Wissensspeicher per Manifest: Wie ein KI-Agent dein Unternehmenswissen strukturiert
Ein KI-Agent liest ein Markdown-Manifest mit acht Fragen und elf Regeln und baut daraus in einer Session einen vollständigen Unternehmenswissensspeicher. Drei Schichten, klare Schreibrechte und getestete Governance. Ohne Vektordatenbank als Fundament und ohne Cloud-Zwang. Der Artikel zeigt den Aufbau und was das für den Betrieb in Deutschland bedeutet.
Obsidian und Second Brains sind im Moment überall, und überall ist der gleiche Screenshot zu sehen: der Graph. Viele Knoten, die schön miteinander verbunden sind, sehen gut aus bei Präsentationen. Der Graph vermittelt zunächst keine Aussage darüber, inwieweit eine Künstliche Intelligenz im Vault effizient arbeiten kann. Eine Maschine hat ein schönes Netzwerk, das keine festen Regeln hat. Es gibt keine Vorschriften, die bestimmen, was sie wie schreiben kann, und keinen Ort, an dem sie zuverlässig findet, was gilt. Der Graph zeigt Verbindungen, aber er ist kein Gedächtnis.
Ich nutze Obsidian seit Monaten. Lange war auch mein Vault eine einfache Ablage mit einem beeindruckenden Graphen. Projekte, Recherchen, Notizen sowie persönliche Ziele waren umfassend erfasst und sorgfältig strukturiert. Für mich, aber nicht für eine KI. Wenn ich meinen Agenten gefragt habe, was er über ein Thema wusste, bekam ich Halbwissen oder Fiktion. Nicht, weil das Modell schlecht ist, sondern weil der Vault eine Struktur hatte, die ein Mensch lesen kann, und keine, die eine Maschine zuverlässig navigieren kann. Ich selbst war der Flaschenhals in dem System. Jede Frage bedeutete Handarbeit, Kontexte zusammenklicken, Dateien durchsuchen oder Ausschnitte kopieren.
Der Unterschied zwischen Ablage und Gedächtnis liegt nicht im Tool. Er liegt in drei Dingen:
– Struktur, die eine Maschine navigieren kann.
– Regeln, die sagen, wer was schreiben darf.
– Und einen Weg, das Wissen abzufragen, ohne es jedes Mal neu zusammenzusetzen.
Genau diese drei Dinge fehlen den meisten Vaults. Der Graph ist Dekoration, aber kein Betriebssystem.
Aufbau eines Agenten, nach acht Fragen
Daraus habe ich eine Struktur entwickelt, die als „Second Brain“ bezeichnet wird und die nicht für Menschen ansprechend gestaltet ist, sondern vielmehr für Maschinen eine navigierbare Form aufweist. Auf diese Weise ist es meinen Agenten möglich, zu jeder Zeit mit dem aktuellen Wissensstand zu arbeiten, ohne dass ich manuell Kontexte zusammensuche.
Meine Lösung ist nicht der übliche Weg über eine App oder eine Datenbank, sondern es ist ein Manifest.
Das Prinzip ist einfach. Ein Agent liest eine Datei mit dem Namen VAULT_BOOTSTRAP_MANIFEST.md. Dann fragt er mich nach der Sprache, den Domains und dem Agent-Gedächtnis. Anschließend baut er den gesamten Wissensspeicher in drei Schichten, 11 verbindlichen Regeln und fünf Kernabläufen selbst auf. Aus reinem Markdown, kein Python, keine Datenbank und keine Installation.
Das System verwendet das Karpathy-LLM-Wiki-Muster: Es nimmt unformatierte Informationen, gibt strukturiertes Wissen aus und fügt Regeln hinzu. Weil es pures Markdown ist, läuft es mit jedem Agenten, der Dateien lesen und schreiben kann, egal ob Claude, Cursor, Gemini, Hermes etc. Man kann einen Agenten wechseln, oder gleich mehrere gleichzeitig benutzen und der Speicher bleibt.
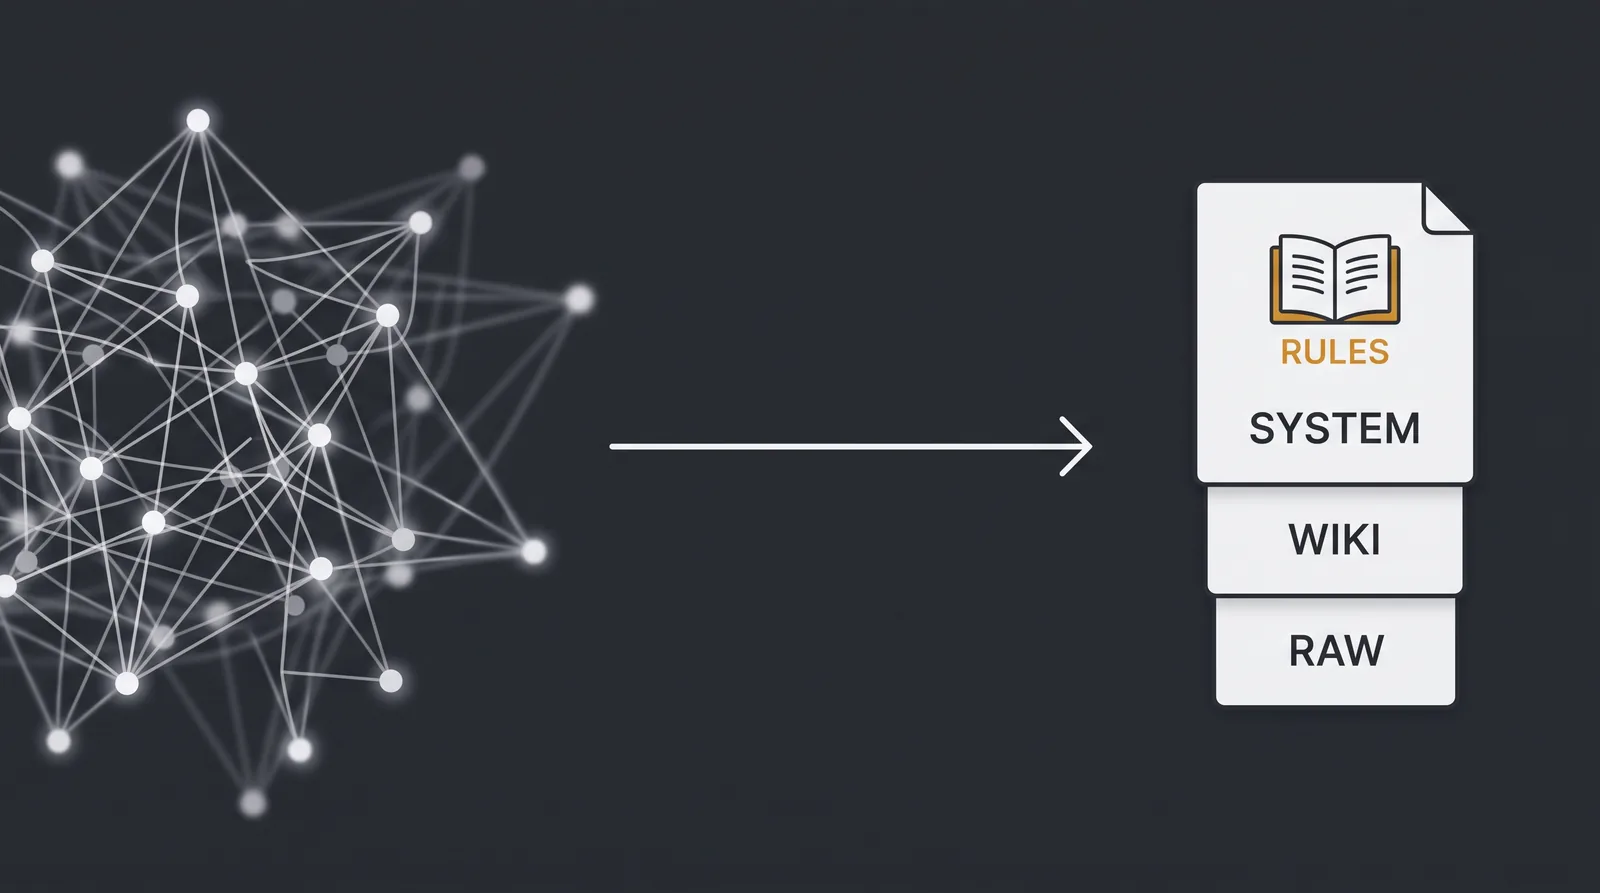
Drei Schichten, eine Hierarchie
Die Architektur in einem kurzen Absatz erklärt. Eine Raw-Schicht für unveränderliche Quellen, eine Wiki-Schicht für vom Agenten aufbereitetes Wissen und eine System-Schicht für Regeln und Abläufe. Eine Ownership-Matrix legt fest, wer welchen Ordner anfassen darf, der Mensch beaufsichtigt die Quellen und der Agent schreibt das Wiki. An der Spitze steht VAULT.md mit 11 verbindlichen Regeln. Darunter gilt die Rangfolge VAULT.md → AGENTS.md → CLAUDE.md → Skills. Fünf wichtige Schritte sorgen dafür, dass alles funktioniert: Informationen aufnehmen, nachschauen, überprüfen, freigeben und messen.
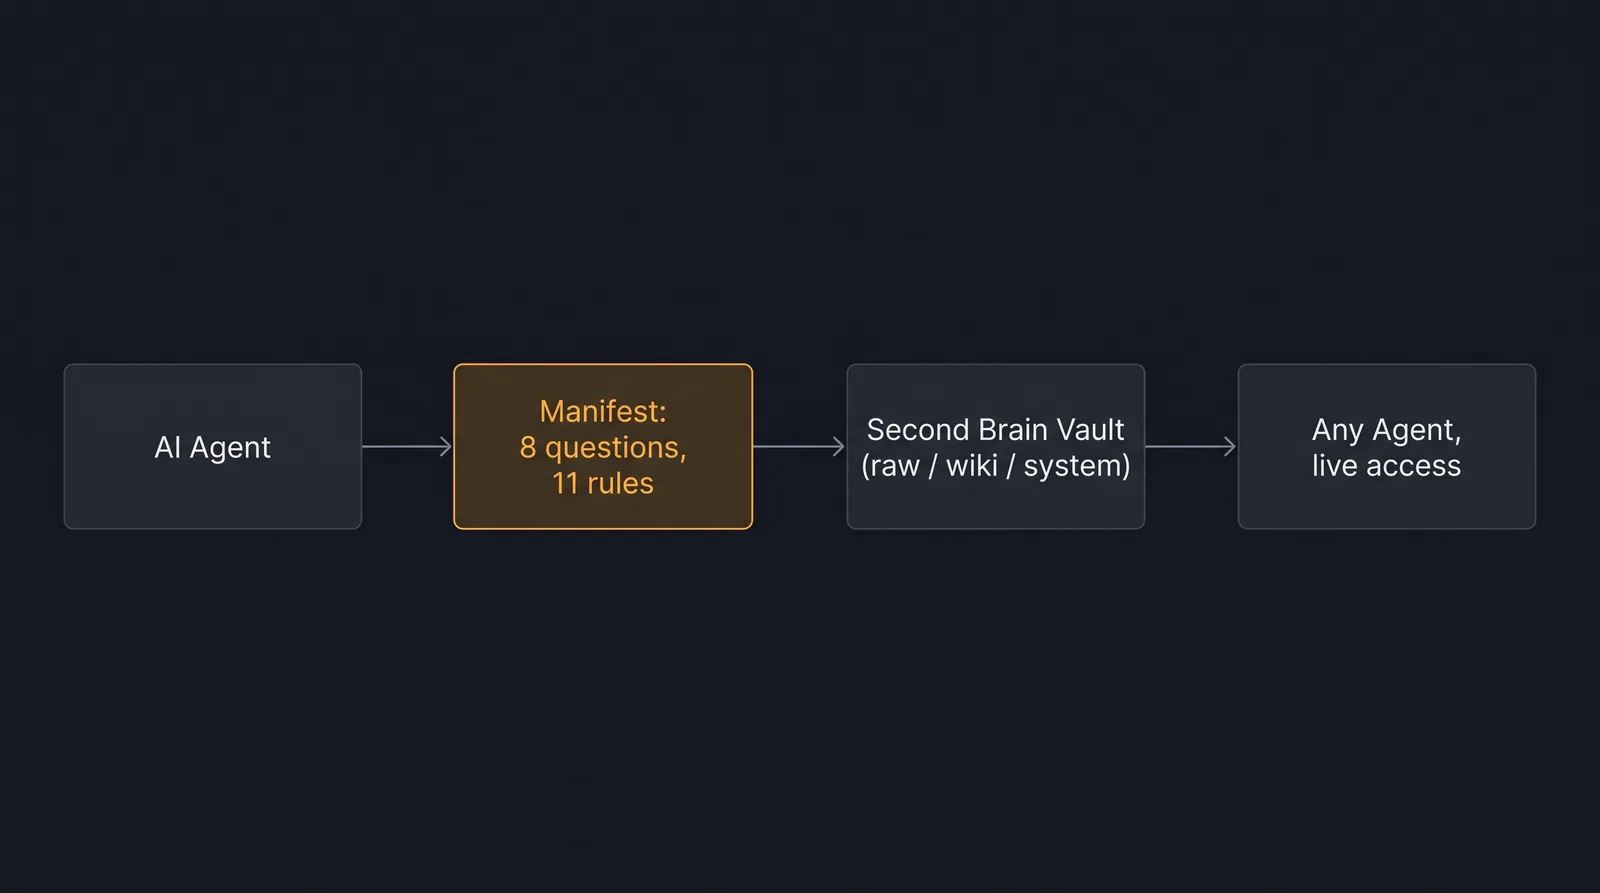
Regeln, die man testen kann
Der eigentliche Unterschied liegt aber woanders. Nicht in der Struktur, sondern in der Disziplin.
Der Speicher kann getestet werden, bevor er produktiv geht. Der Abnahmetest läuft zweiteilig: Erst wird das Manifest selbst geprüft, dann der gebaute Vault. Struktur, Frontmatter, JSON-Gültigkeit, Verlinkungen. Sollte etwas nicht in Ordnung sein, wird der Vault nicht als abgeschlossen betrachtet.
Im Betrieb überwacht ein Lint-Check sieben Punkte. Einer davon ist veraltetes Wissen. Wenn eine Aussage im Wiki nicht mehr zutreffend ist, da eine neuere Quelle diese korrigiert hat, wird dies vom System gemeldet. Es erkennt auch verwaiste Seiten, fehlende Konzepte, und driftende Indizes.
Und weil bei mir mehrere Agenten auf den Speicher zugreifen, koordinieren sie sich über ein Write-Log, nicht über Lock-Files und nicht über eine zentrale Instanz. Jeder Schreibvorgang wird angehängt, nie überschrieben. Konflikte erkennt das System aus überlappenden Einträgen. Verstößt ein Agent gegen eine Schreibregel, gibt es eine Remediation-Prozedur, die den Schaden behebt, statt ihn zu verstecken.
Der Health-Score macht aus dieser Disziplin eine Zahl. Nach dem ersten Ingest lag er bei 78 %. Startpunkt unter 100%, weil man verwaiste Links und fehlende Metadaten erst im Betrieb sieht. Alle Probleme wurden identifiziert und behoben, bevor es produktiv geht. (Stand August 2026. Das Projekt lebt und entwickelt sich weiter.)
Ein Score unter 100 % klingt erst einmal falsch, aber ich halte es für ehrlich. Der Score ist ein Betriebswert, kein Marketingwert: Ein System, das bei der Abnahme schon 100 % zeigt, hat entweder einen zu leichten Test oder lügt.
Warum keine Vektordatenbank?
Eine Frage, die man sich häufig stellen kann, ist: Warum nicht einfach eine Vektordatenbank als zentrale Wissensbasis?
Weil eine Vektordatenbank etwas anderes tut, als die meisten denken. Sie arbeitet auf einem Snapshot, dem Stand zum Zeitpunkt des Einbettens. Meine Agenten arbeiten auf dem echten, aktuellen Vault. Kommt eine Datei dazu, ist sie sofort da. Wird eine Aussage korrigiert, ist die alte weg.
Und falls semantische Suche doch mal gebraucht wird, unterstützt das System dafür eine Schnittstelle. Das Setup fragt explizit nach externem Speichern. Die Vektordatenbank stellt in diesem Kontext kein Fundament dar, sondern fungiert als ein Baustein, der bei Bedarf an den spezifischen Anwendungsfall angedockt wird.
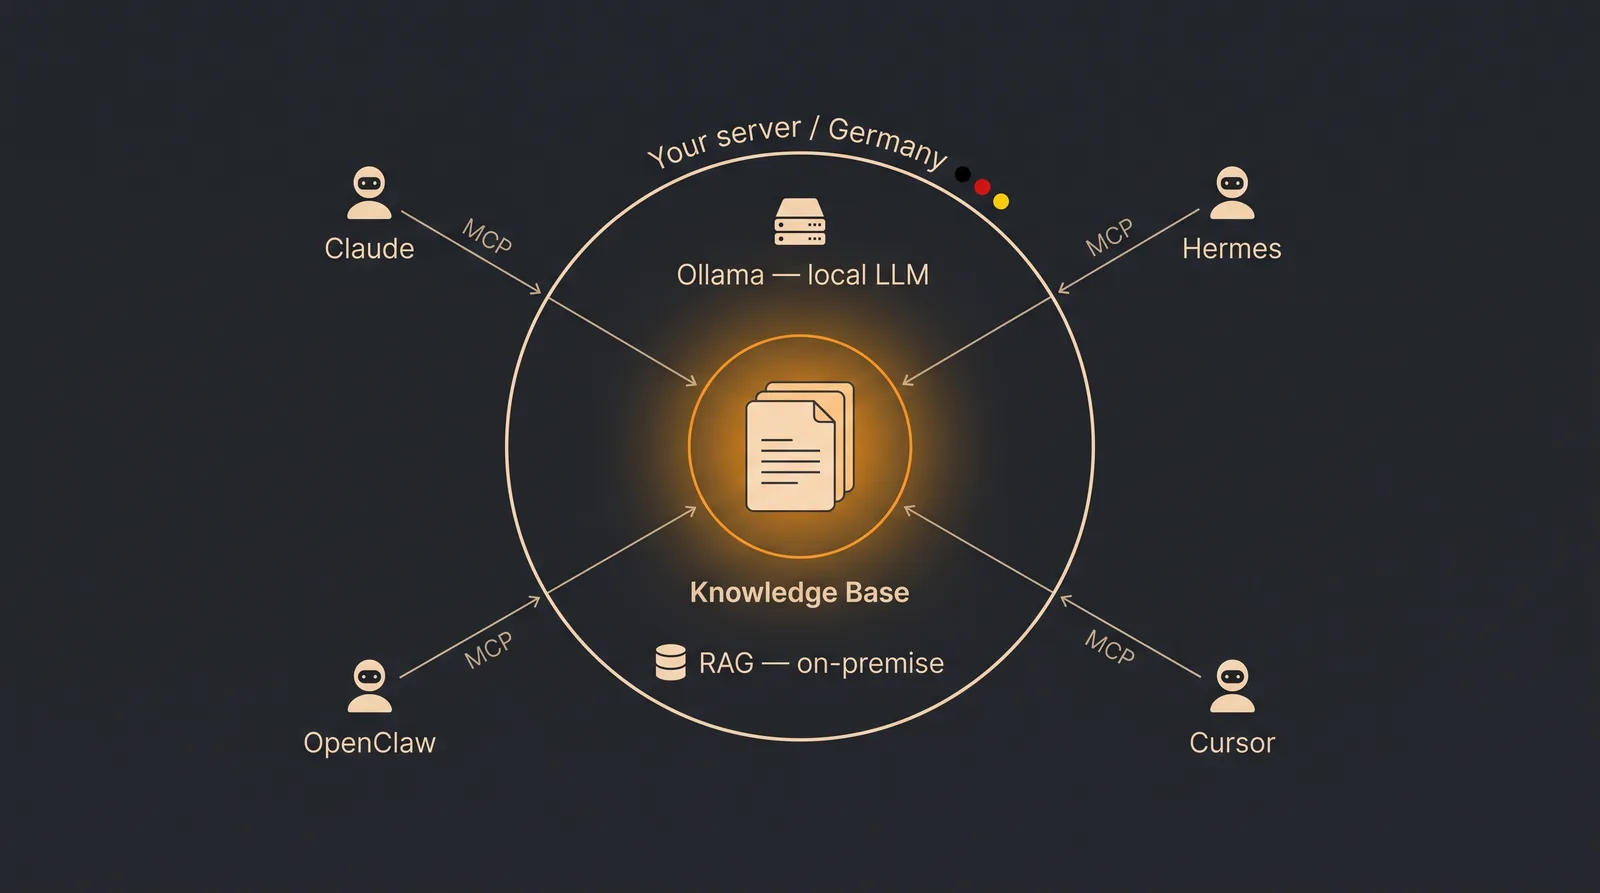
Sovereign heißt: Du entscheidest pro Schicht.
Eine weitere Frage, die sich gerade in Deutschland oft stellt, ist die nach dem Datenschutz.
Die Daten bleiben auf deinem Server. Das Vault ist reines Markdown, kein Cloud-Zwang, kein Vendor-Lock-in. Weil das System headless läuft, also ohne Desktop-App, ist es containerisierbar und läuft damit auch in der eigenen Kubernetes-Umgebung. Und hier trenne ich zwei Schichten, die oft vermischt werden: Die Datenschicht (Vault, Manifest, Write-Logs) verlässt deinen Server nie. Du hast die Wahl zwischen einer vollständig lokalen Modellschicht (z. B. mit Ollama), einem LLM, das in Deutschland oder der EU gehostet wird (z. B. über STACKIT), oder einer US‑API. In diesem Fall befinden sich die Prompt- und Inhaltsdaten bei dem jeweiligen Anbieter in den Vereinigten Staaten. Sovereign heißt hier, dass du pro Schicht entscheidest, statt es dem Tool zu überlassen.
Für deutsche Unternehmen ist das keine Ideologie, sondern eine Frage der Sicherheit. Der EU-AI-Act verlangt bereits KI-Kompetenz im Unternehmen (Art. 4 gilt seit Februar 2025). Und wer einen bestehenden KI-Stack wesentlich umbaut oder für neue Zwecke einsetzt, kann nach Art. 25 selbst in die Anbieter-Rolle wechseln und trägt dann die damit verbundenen Pflichten. Bei Hochrisiko-Systemen ist das die Regel, nicht die Ausnahme. Wer sein Wissenssystem selbst aufsetzt, sollte wissen, dass die Verantwortung damit nicht verschwindet, sondern sichtbar bleibt.
Erprobt habe ich das mit meinem Agenten im Alltag. Ich stelle eine Frage, der Agent greift auf den Vault zu und antwortet mit Quellenangabe, live und ohne Cloud-Umweg.
Was sind die nächsten Schritte?
Als Nächstes stelle ich eine standardisierte Zugriffsschicht über MCP vor, damit jeder Agent den Speicher mit definierten Tools statt rohen Dateizugriffen erreicht. Zusätzlich dazu eine RAG-Andockung für die Fälle, in denen semantische Suche über riesige unstrukturierte Bestände wirklich gebraucht wird. Das Deployment-Ziel besteht in der Sovereign Cloud, um sicherzustellen, dass der gesamte Prozess vom Code bis zur EU-Cloud lückenlos bleibt.
Die gesamte Software ist Open Source: github.com/nakielski/second-brain
Ein intelligenter Agent liest nicht alles, er weiß, wo die richtigen Informationen stehen.
Was hält euch von einem dateibasierten Gedächtnis ab?