Bedeutung braucht Regeln: Warum meine KI-Agenten nicht direkt im Vektorindex suchen dürfen
Wochenlang antworteten meine Agenten aus einem unvollständigen Suchindex, nach der Reparatur fanden sie plötzlich Notizen, die sie ohne Freigabe nie hätten finden dürfen.
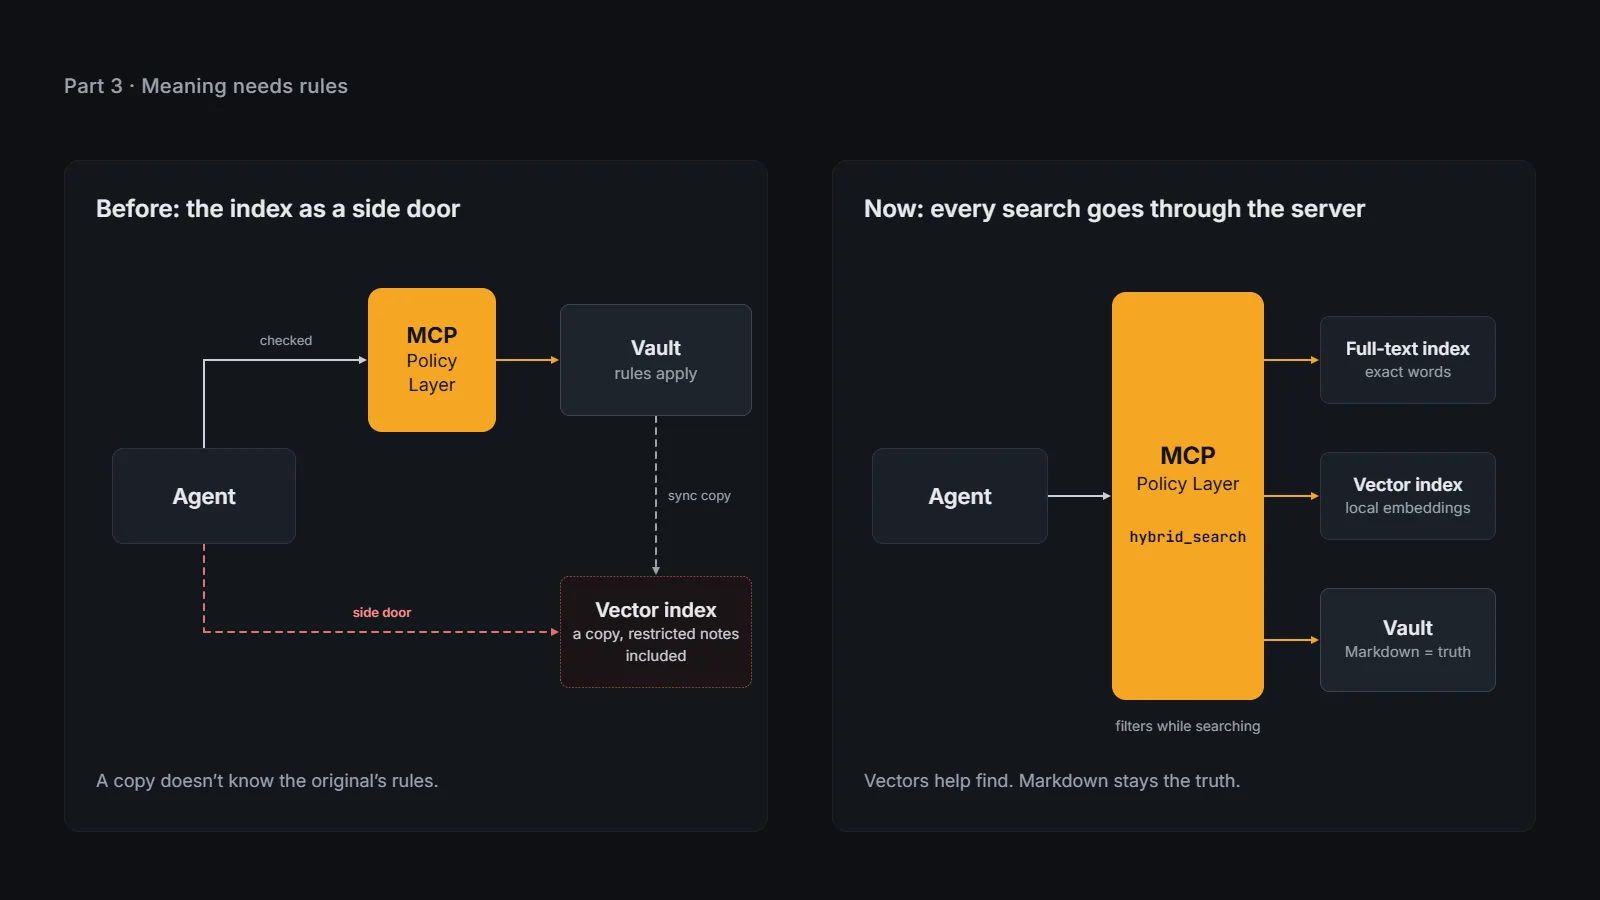
Wochenlang haben meine Agenten Fragen zu meinem Wissensspeicher beantwortet und die Antworten klangen plausibel. Was niemand bemerkt hat: Der Index, aus dem sie schöpften, kannte nur einen Bruchteil vom tatsächlichen Inhalt. Ein Sync-Skript sollte den Speicher regelmäßig in das Gedächtnis meiner Agenten spiegeln. Nur verwies das Skript auf Ordner, die unter diesen Namen gar nicht existierten. Alle Projekt- und Arbeitsbereiche meldeten bei jedem Lauf „0 files“, nur das Wiki kam an. Kein Fehler, kein Alarm. Aufgefallen ist es erst, als ich in Bezug auf eine ganz andere Sache nachgefragt habe.
Die Reparatur hat das Problem dann verschoben statt gelöst. Mit den richtigen Pfaden landeten plötzlich auch meine Notizen über Personen im Index. Informationen, die meine Agenten nicht ohne ausdrückliche Freigabe abrufen sollten, waren damit über die Suche erreichbar. Im Index galt diese Regel nicht. Er war eine Kopie und eine Kopie kennt die Regeln des Originals nicht.
Im vorhergehenden Teil dieser Serie habe ich beschrieben, wie ein MCP-Server die Schreibregeln meines Speichers durchsetzt. Am Ende stand die Frage, was passiert, wenn Struktur und Volltextsuche allein nicht mehr reichen. Meine ehrliche Antwort: Wer nicht aufpasst, baut sich eine Seitentür.
Warum Volltext nicht mehr reicht
Mein Speicher umfasst inzwischen tausende Notizen. Deutsche und englische Begriffe mischen sich, dasselbe Thema heißt in einer Notiz „Prompt-Injection“ und in der nächsten „manipulierte Anweisungen“. In einer Volltextsuche wird nur das gefunden, was wörtlich dort steht. Bei meinem Server musste jedes Wort der Frage in der Notiz vorkommen oder ich musste hoffen, dass der KI-Agent nach den richtigen Wörtern sucht.
Ein Beispiel: „How do I keep customer data out of Copilot?“. Die passende Notiz existiert in Form einer deutschen Recherche zu Daten und Sicherheit in Copilot. Die Volltextsuche findet sie dennoch nicht. Eine semantische Suche berücksichtigt die inhaltliche Ähnlichkeit statt einzelner Suchwörter. In meinem Test landete genau diese Notiz auf Platz eins.
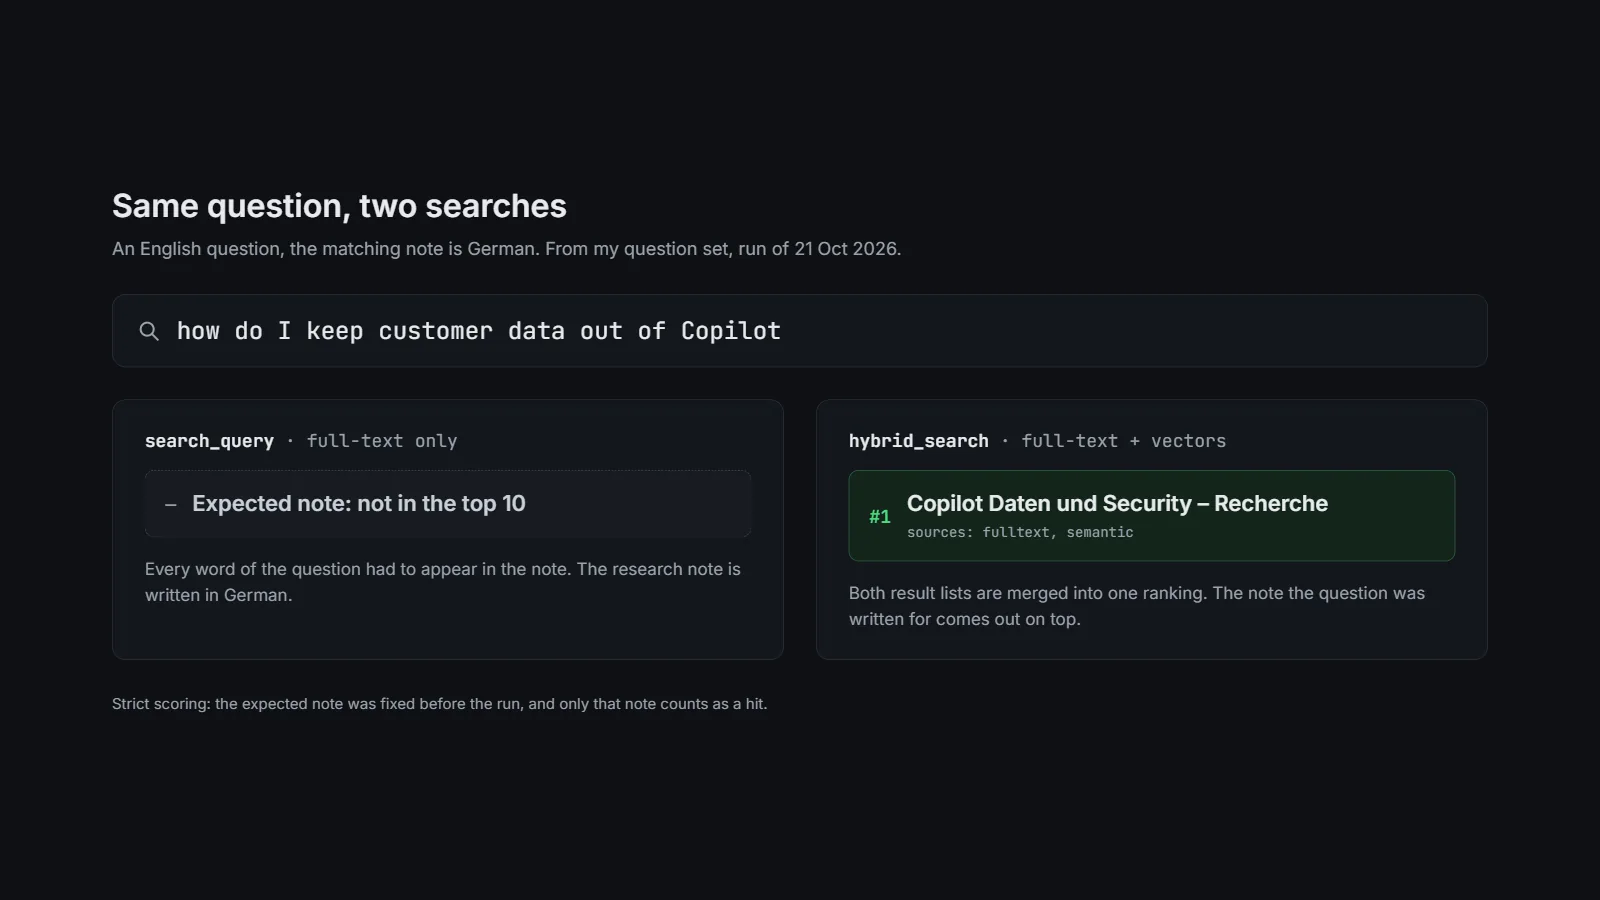
Agenten fragen selten in Stichworten. Sie formulieren wie Menschen, oft in der Sprache, in der das Gespräch geführt wird, und nicht in der Sprache der Notiz. Für sie ist eine reine Volltextsuche halb blind.
Ein unkontrollierter Vektorindex wird zur Seitentür
Die naheliegende Lösung ist ein Vektorindex: Notizen in Abschnitte zerlegen, als Vektoren speichern und nach Ähnlichkeit suchen. Die Werkzeuge dafür gibt es fertig und genau darin liegt das Risiko.
Ein Vektorindex enthält eine abgeleitete Sicht auf das Wissen. Ändert sich das Original, muss diese Sicht aktualisiert werden. Zugriffsregeln übernimmt sie nicht automatisch. Wer gesperrte Bereiche schützen will, muss die entsprechenden Regeln auch bei der Suche durchsetzen. Kann ein Agent den Index direkt und ungefiltert abfragen, entsteht ein Weg an der Kontrollschicht vorbei.
Bei der Bestandsaufnahme fand ich zwei solche Kopien meines Speichers: den oben beschriebenen Sync und eine ältere Vektor-Sammlung. Bewusst hatte ich mich für keine von beiden entschieden. Sie sind beim Ausprobieren entstanden und dann geblieben. Dazu kam eine dritte Lücke im eigenen Server: Die Personen-Sperre griff zwar beim direkten Lesen, aber die bisherige Volltextsuche lieferte diese Notizen ungefiltert aus.
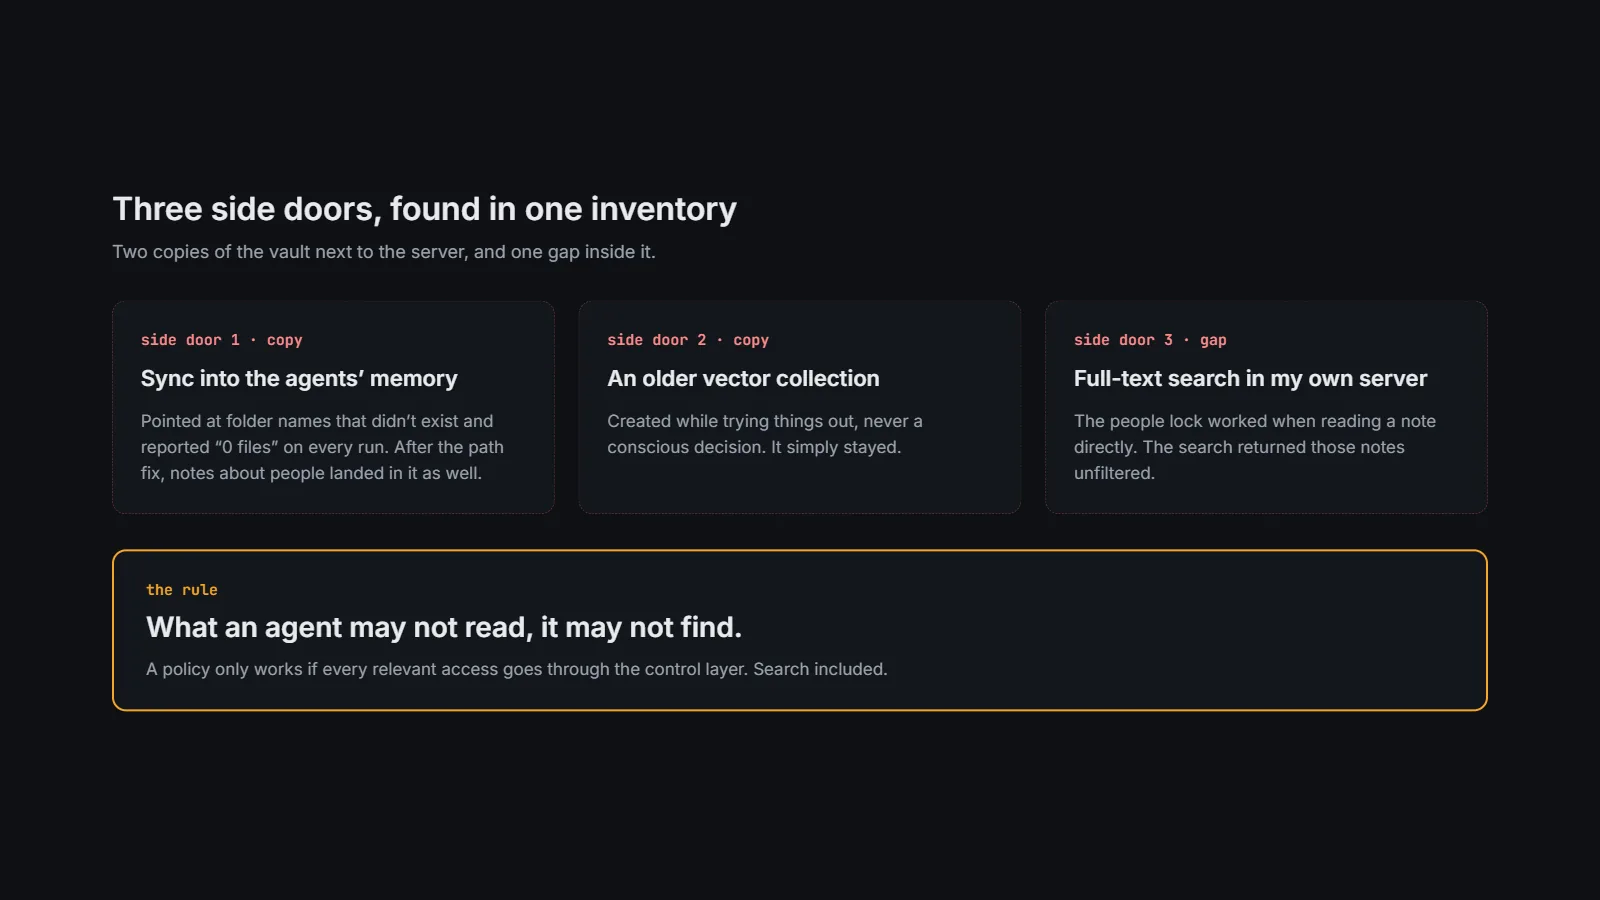
Ein Satz aus dem letzten Artikel gilt deshalb auch hier: Eine Richtlinie wirkt nur, wenn jeder relevante Zugriff durch die Kontrollschicht läuft. Für die Suche heißt das: Was ein Agent nicht lesen darf, darf er auch nicht finden.
Gesprächsgedächtnis und Wissensindex haben unterschiedliche Aufgaben
Mein erster Ansatz war, den Speicher einfach weiter in das vorhandene Gesprächsgedächtnis meiner Agenten zu spiegeln. Ich hatte schon ein Gesprächsgedächtnis im Einsatz und dieses konnte bereits semantisch suchen. Nach dem Vorfall mit den Personen-Notizen habe ich diesen Weg jedoch verworfen:
Mein Gesprächsgedächtnis verdichtet Informationen mithilfe eines Sprachmodells zu Erinnerungen. Für die Suche nach Originalnotizen wollte ich aber keine Interpretation, sondern nachvollziehbare Fundstellen.
Ältere Einträge werden in meiner Implementierung als veraltet markiert, aber nicht unmittelbar gelöscht. Fehlt bei einer Abfrage der passende Filter, kann auch eine alte Fassung auftauchen. Ein Suchindex soll den aktuellen Stand abbilden, nicht die Geschichte.
Mein Gesprächsgedächtnis trennt die Zugriffe der Agenten nicht. Wer es abfragen darf, sieht alles.
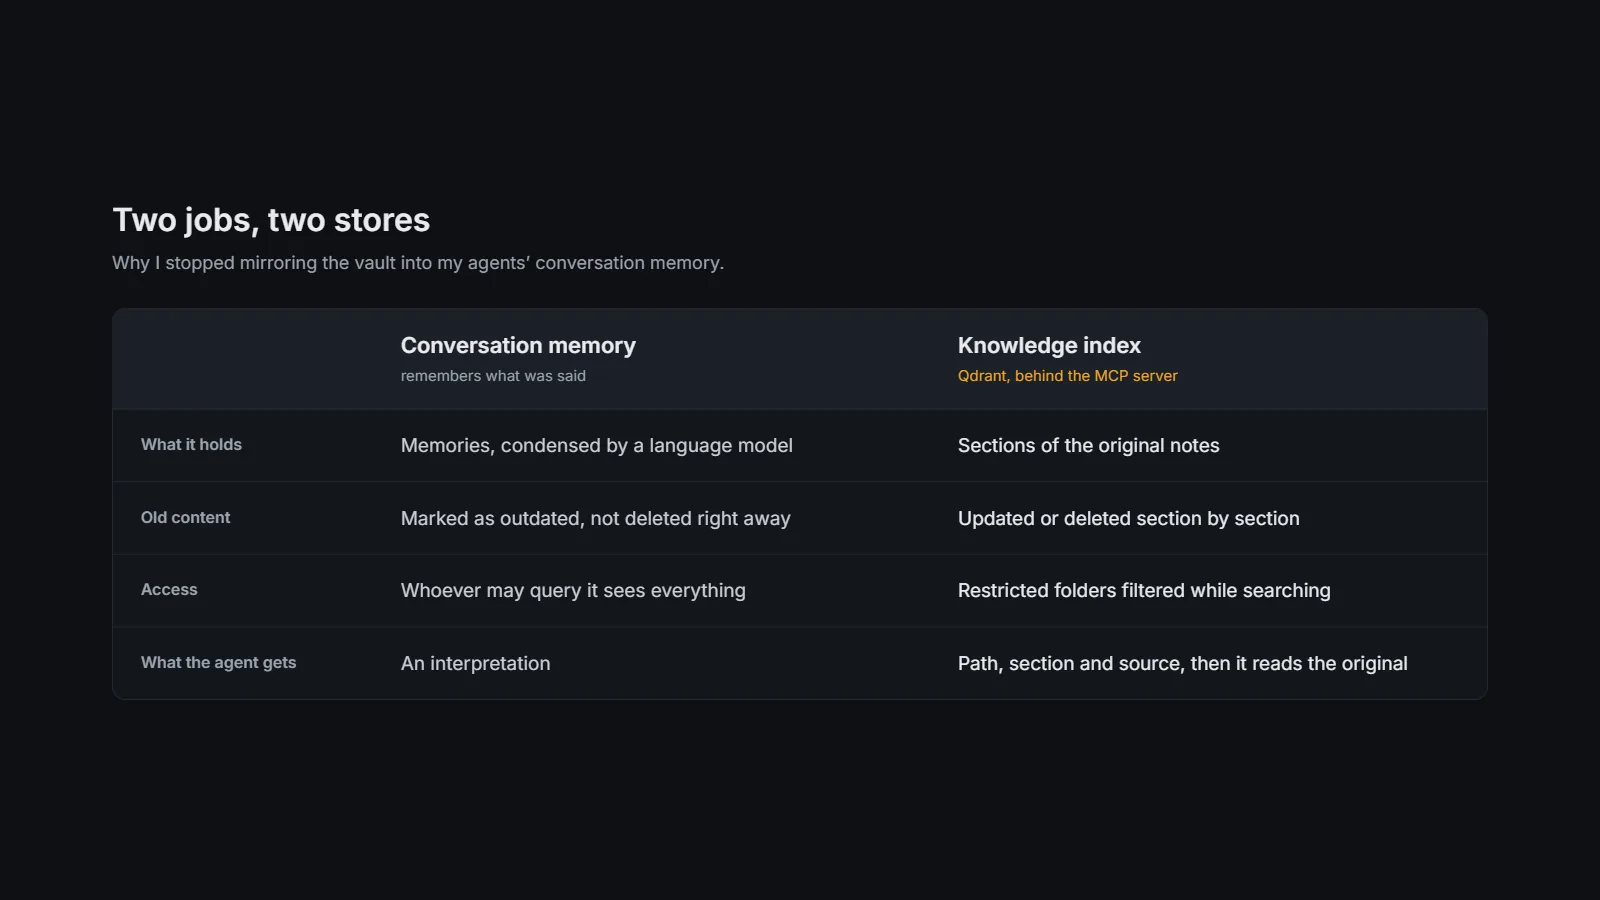
Den alten Sync habe ich deshalb abgeschaltet. Qdrant lief ebenfalls schon auf dem Server. Dort kann ich einzelne Abschnitte gezielt aktualisieren oder löschen und gesperrte Ordner bereits bei der Suche herausfiltern. Der Index ist zusätzlich über einen eigenen Schlüssel geschützt. Welche Inhalte ein Agent finden darf, entscheidet aber weiterhin mein MCP-Server.
Die Suche sollte auf demselben Server durchgeführt werden
Die semantische Suche ist kein eigener Dienst geworden, sondern ein weiteres Werkzeug auf meinem MCP‑Server. Es fragt beide Wege gleichzeitig ab, Volltext und Vektoren, und führt die Trefferlisten zusammen. Dabei gelten dieselben Regeln wie für jeden Lesezugriff:
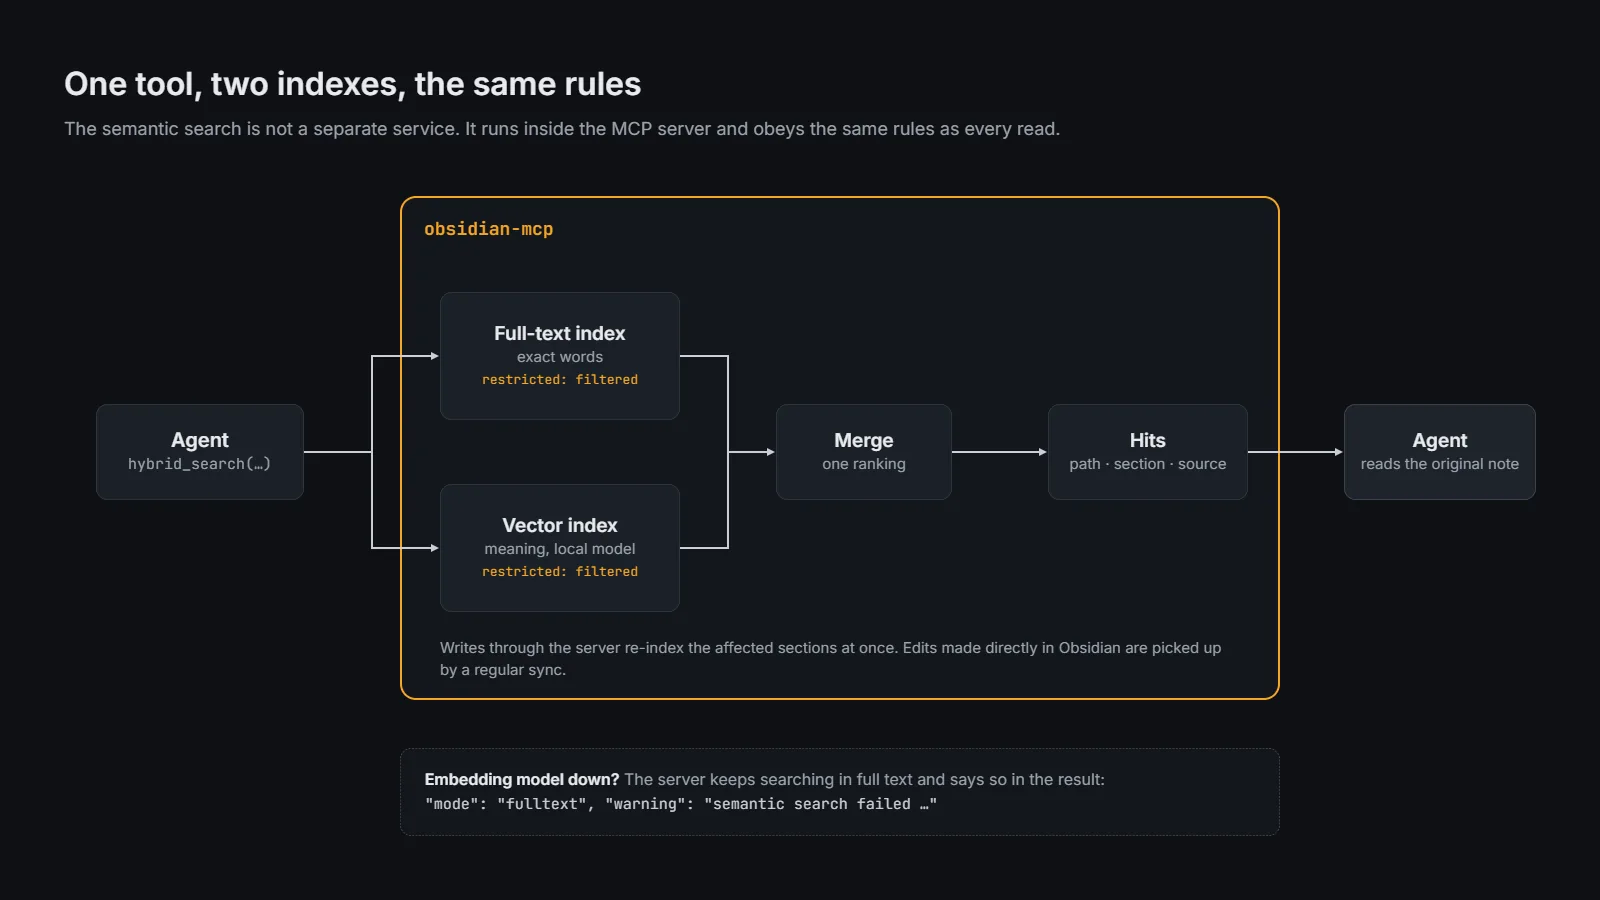
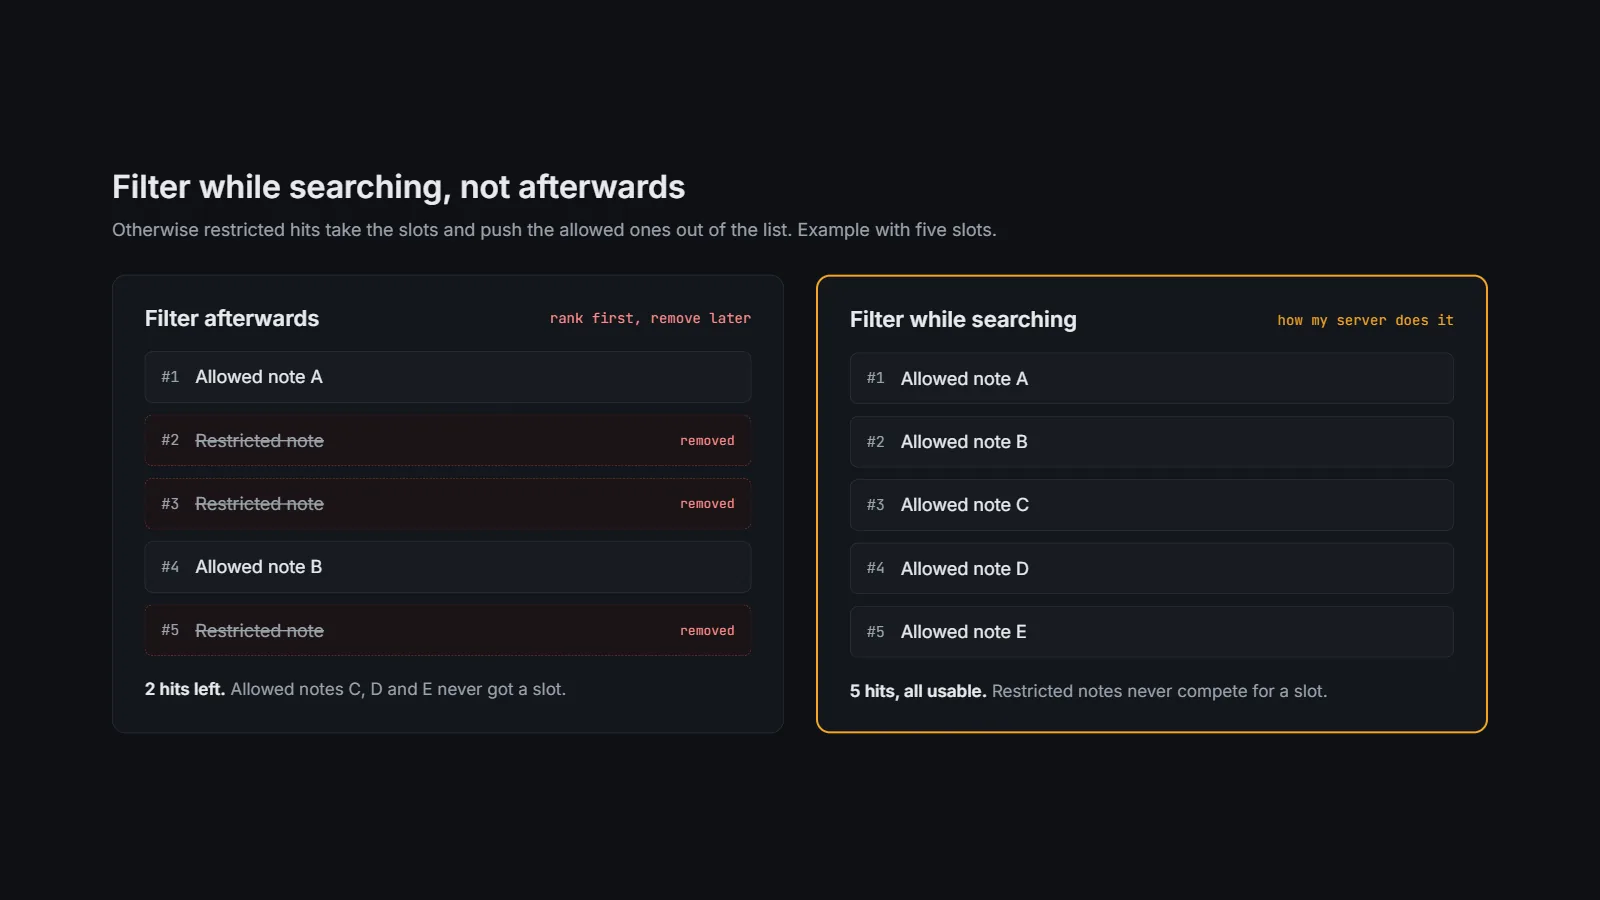
Gesperrte Ordner werden schon beim Durchsuchen gefiltert, nicht erst danach. Sonst würden verbotene Treffer die erlaubten aus der Liste drängen.
Geschützte Bereiche wie Protokolle und Konfiguration werden gar nicht erst als Vektoren gespeichert.
Ändert ein Agent eine Notiz, stößt der Server unmittelbar die Aktualisierung der betroffenen Abschnitte im Index an. Änderungen außerhalb des Servers, etwa direkt in Obsidian, werden durch einen regelmäßigen Abgleich erfasst.
Jeder Treffer enthält Pfad, Abschnitt und Herkunft. Der Agent liest danach das Original, nicht den Auszug.
Die Vektoren berechnet ein lokales Modell auf meiner eigenen Hardware, die Notizinhalte verlassen dafür meine Infrastruktur nicht. Fällt die semantische Seite aus, sucht der Server im Volltext weiter und informiert im Ergebnis auch darüber. Während ich an diesem Text gearbeitet habe, ist genau das auf meinem Notebook passiert: Das lokale Modell lief nicht, die Suche lieferte trotzdem Treffer und einen klaren Hinweis darauf, dass nur im Volltext gesucht wurde.
Messen statt Bauchgefühl
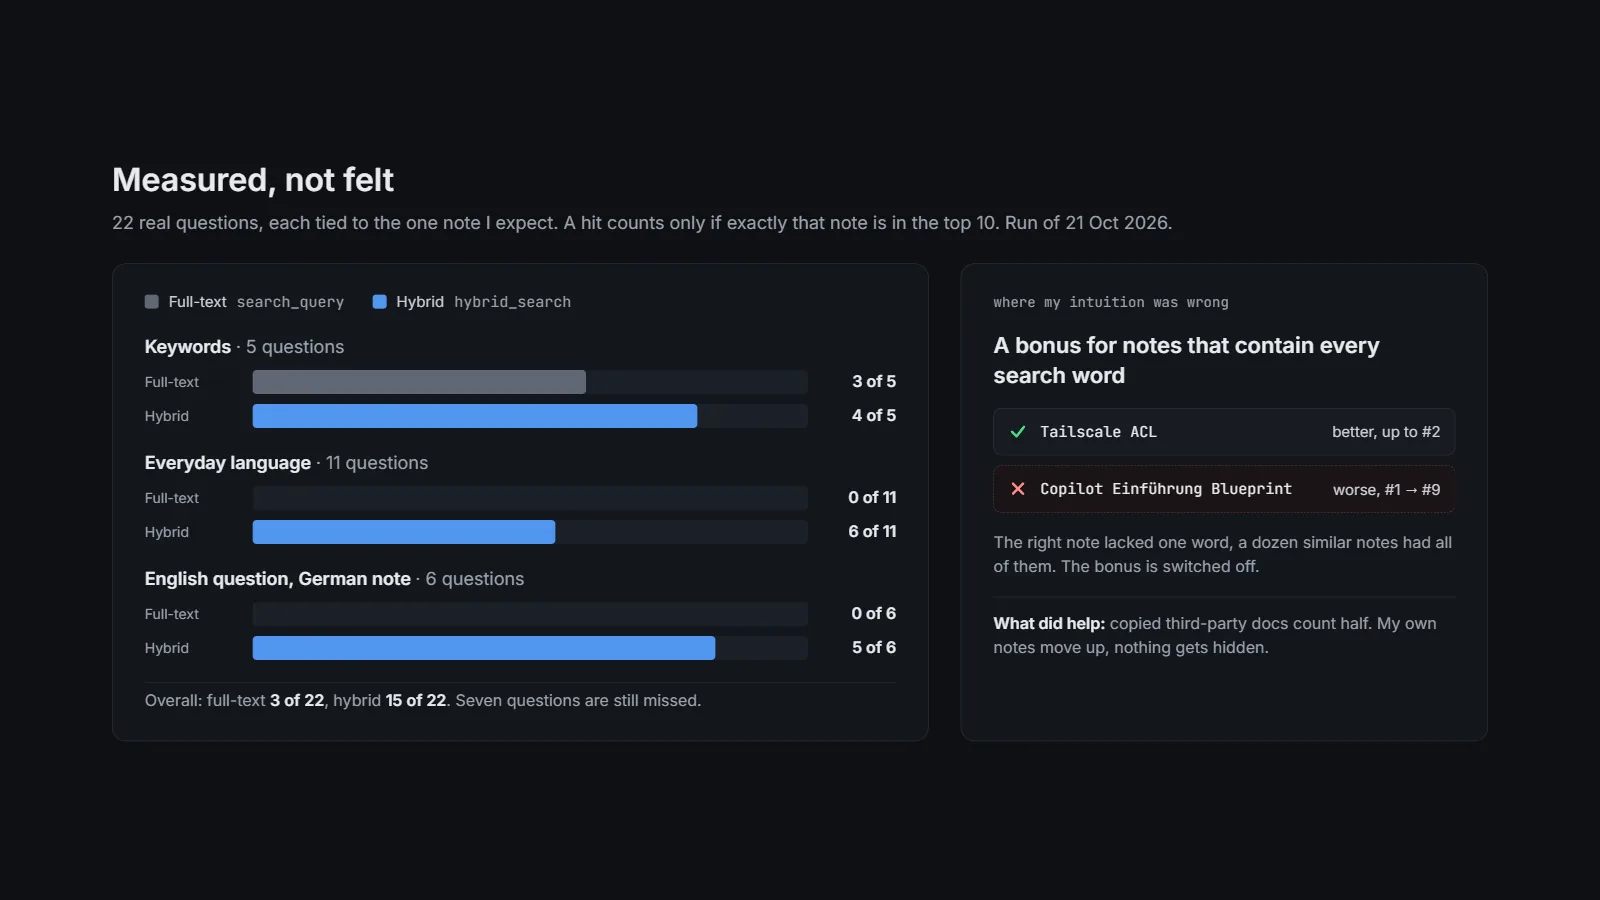
Ob eine Suche gut ist, lässt sich nicht nach Gefühl entscheiden. Um die Suchqualität objektiv zu prüfen, habe ich einen festen Katalog aus echten Suchanfragen definiert, jeweils verknüpft mit der Notiz, die ich als Treffer erwarte. Die Bandbreite reicht von einzelnen Stichworten über frei formulierte Sätze bis hin zu englischen Anfragen für deutsche Inhalte. Gerade bei Alltagssprache fand die reine Volltextsuche keine einzige der erwarteten Notizen. Die Hybrid-Suche fand dagegen auch bei frei formulierten und sprachübergreifenden Fragen passende Ergebnisse. Das Fragenset zeigte aber ebenso, dass nicht jede vermeintliche Verbesserung tatsächlich eine war.
Spannender als das Ergebnis war der Weg dorthin. Beim ersten Test tauchte der beste semantische Treffer gar nicht auf, weil mehrere Fassungen desselben Artikelentwurfs die vorderen Plätze belegten. Auch beim anschließenden Feinschliff am Ranking lag meine erste Intuition daneben: Notizen, die alle Suchwörter enthielten, sollten einen Bonus bekommen. Eine Stichwortfrage wurde dadurch besser, eine andere rutschte vom ersten Platz weit nach hinten. Der richtigen Notiz fehlte ein einziges Wort, ein Dutzend ähnlicher Notizen enthielt alle. Ohne Fragenset hätte ich die Änderung für einen Erfolg gehalten.
Einen echten Mehrwert brachte dagegen etwas Unspektakuläres: In meinem Speicher liegen neben eigenen Gedanken auch kopierte Handbücher und Dokumentationen Dritter. Solche externen Quellen gewichte ich bei der Suche nur noch halb so stark. Damit rücken meine eigenen Notizen nach vorn, ohne dass das Nachschlagewerk ausgeblendet wird. Das Fragenset bleibt als Regressionstest. Jede Änderung am Ranking oder am Modell muss sich daran messen lassen.
Wo die Grenze liegt
Im ersten Artikel habe ich bewusst auf eine Vektordatenbank als Fundament verzichtet. Nicht, weil semantische Suche grundsätzlich überflüssig wäre, sondern weil ein Index nicht zur maßgeblichen Wissensquelle werden sollte. Daran hat sich nichts geändert. Neu ist nur, dass mein Speicher inzwischen eine zusätzliche Suchmethode benötigt. Die Vektoren helfen beim Finden, die Markdown-Dateien bleiben die Wahrheit.
Auch semantische Suche findet Plausibles, aber nicht automatisch Richtiges. Einige Fragen aus meinem Fragenset beantwortet sie bis heute nicht zuverlässig. Die passende Notiz steht zu weit hinten oder taucht gar nicht in den Treffern auf. Deshalb liefert der Server Fundstellen und keine fertigen Antworten. Der Agent muss das Original lesen und die Informationen selbst einordnen.
Fertig ist das System damit nicht und das soll es auch nicht sein. Es läuft jeden Tag, die Messung zeigt mir, wo es schwächelt, und ich entwickle es regelmäßig weiter. Jede Verbesserung muss sich am selben Fragenset beweisen.
Der Preis ist überschaubar, aber real: ein zusätzlicher Index, der aktuell gehalten werden muss, Rechenzeit für die Vektorberechnung und die Disziplin, die Suchqualität regelmäßig zu überprüfen. Nach Bedeutung zu suchen, ist ein mächtiges Werkzeug. Genau deshalb muss sie durch exakt dieselbe Kontrollschicht laufen wie jeder andere Zugriff.
Bleibt eine Frage, die mich seit dem unbemerkten Indexfehler nicht loslässt: Wochenlang lief etwas falsch und weder ich noch ein Agent hat es gemerkt. Eine Kontrollschicht verhindert Regelverstöße beim Zugriff. Wer aber prüft, ob die Abläufe als Ganzes stimmen? Darum geht es im nächsten Teil.
Wo liegen bei euch die semantischen Kopien eurer Wissensbestände und wer entscheidet, was eure Agenten darin finden dürfen?