Eine Wahrheit, viele Agenten: Wie ein MCP-Server meinen Wissensspeicher kontrolliert
Was passiert, wenn KI-Agenten wichtige Regeln im Prompt vergessen? Ich zeige, wie ein eigener MCP-Server den Zugriff auf meinen Wissensspeicher kontrolliert, Schreibregeln durchsetzt und mehrere Agenten nach denselben Regeln arbeiten lässt.
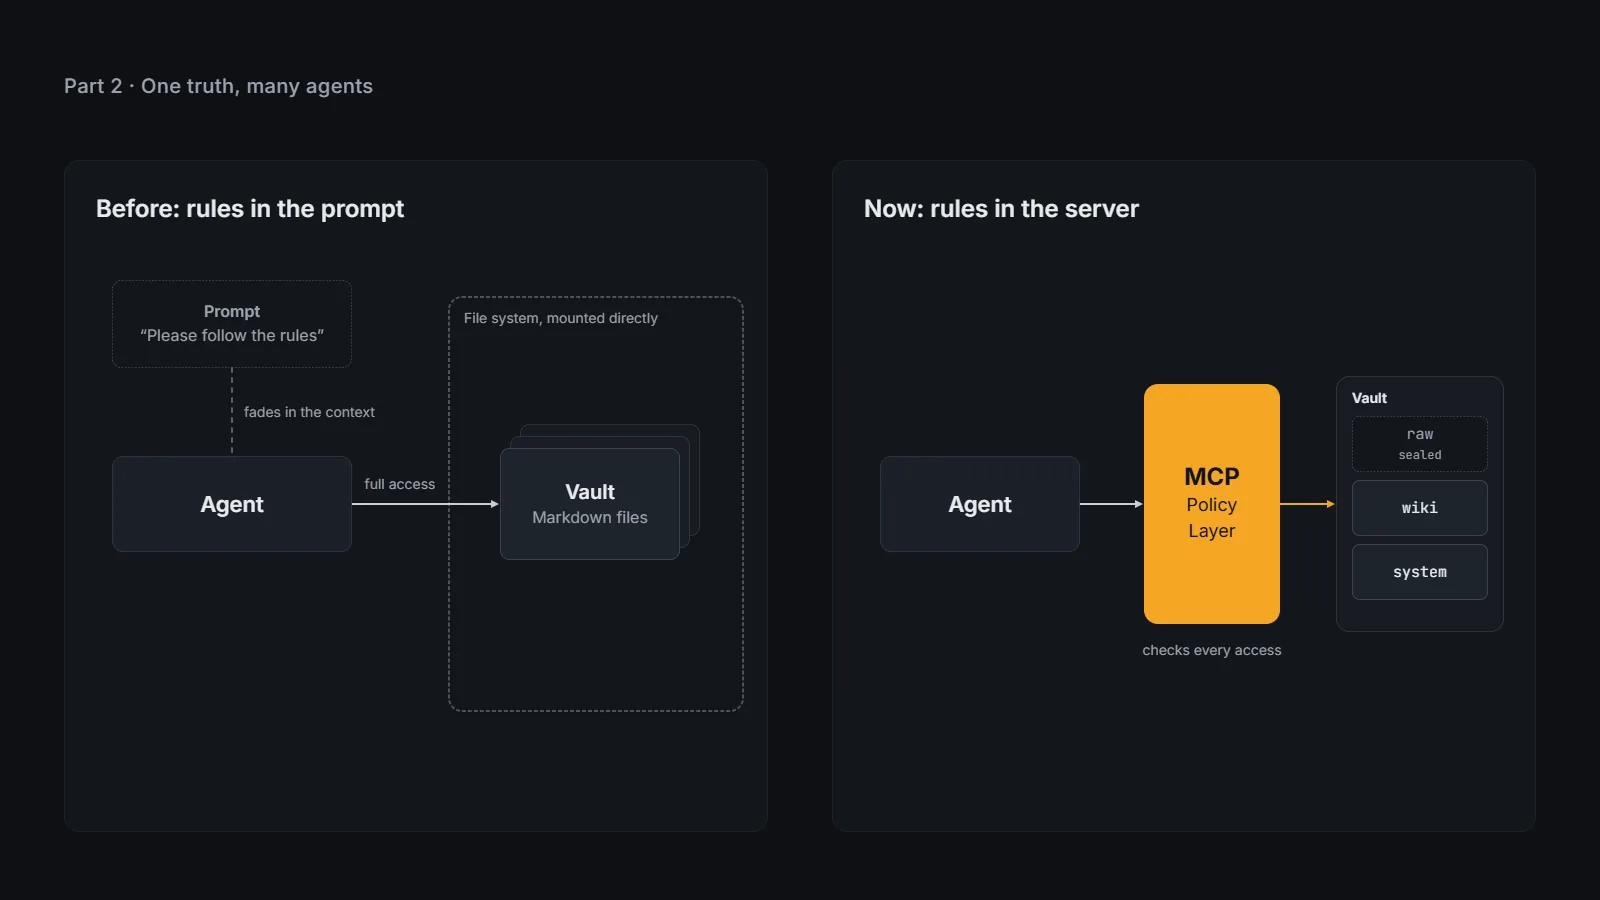
Wer heute KI-Agenten für Unternehmen entwickelt, legt ihre Regeln oft im Prompt fest. Doch je länger das Gespräch dauert und je mehr Informationen hinzukommen, desto leichter geraten die ursprünglichen Regeln in den Hintergrund.
Ich habe einige Zeit genauso gearbeitet. Der Wissensspeicher, den ich im ersten Teil dieser Serie beschrieben habe, wurde den Agenten in Form eines Dateibaums präsentiert. Die Regeln dazu standen im Manifest und in den vorhergehenden System-Prompts. Es hat funktioniert. Meistens. Und „meistens“ reicht nicht aus, um einen Kunden oder sich selbst zufrieden zu stellen.
Vereinbarungen gelten nur, solange der Agent mitmacht
Ein Prompt ist eine Bitte. Sie gilt für ein Modell, in einem Kontextfenster, für eine Sitzung. Kommt ein neuer Client dazu, muss die Bitte wiederholt werden. Wenn das Kontextfenster ausgeschöpft ist, wird der bisherige Gesprächsverlauf komprimiert. Dabei können einzelne Regeln oder wichtige Details verloren gehen. Und ein Agent, der das Dateisystem direkt gemountet bekommt, braucht die Bitte gar nicht. Er öffnet die Datei trotzdem.
Ich konnte das selbst beobachten. Regeln, die ich mehrfach in den Kontext geschrieben hatte, waren nach einigen Werkzeugaufrufen nicht mehr präsent. Kein Modell, das mich ärgern wollte. Der Kontext ist schlicht kein Ort, an dem Regeln zuverlässig überleben.
In Organisationen vervielfacht sich das Problem. Jedes Team pflegt seine eigene Prompt-Version, die Versionen driften auseinander und wenn nach einem Fehler die Frage aufkommt, welche Regel denn nun galt, kann sie niemand beantworten. Was fehlt, ist eine Stelle, an der die Regel durchgesetzt wird, egal, wer damit arbeitet.
Was der Server macht, muss sonst der Prompt erledigen
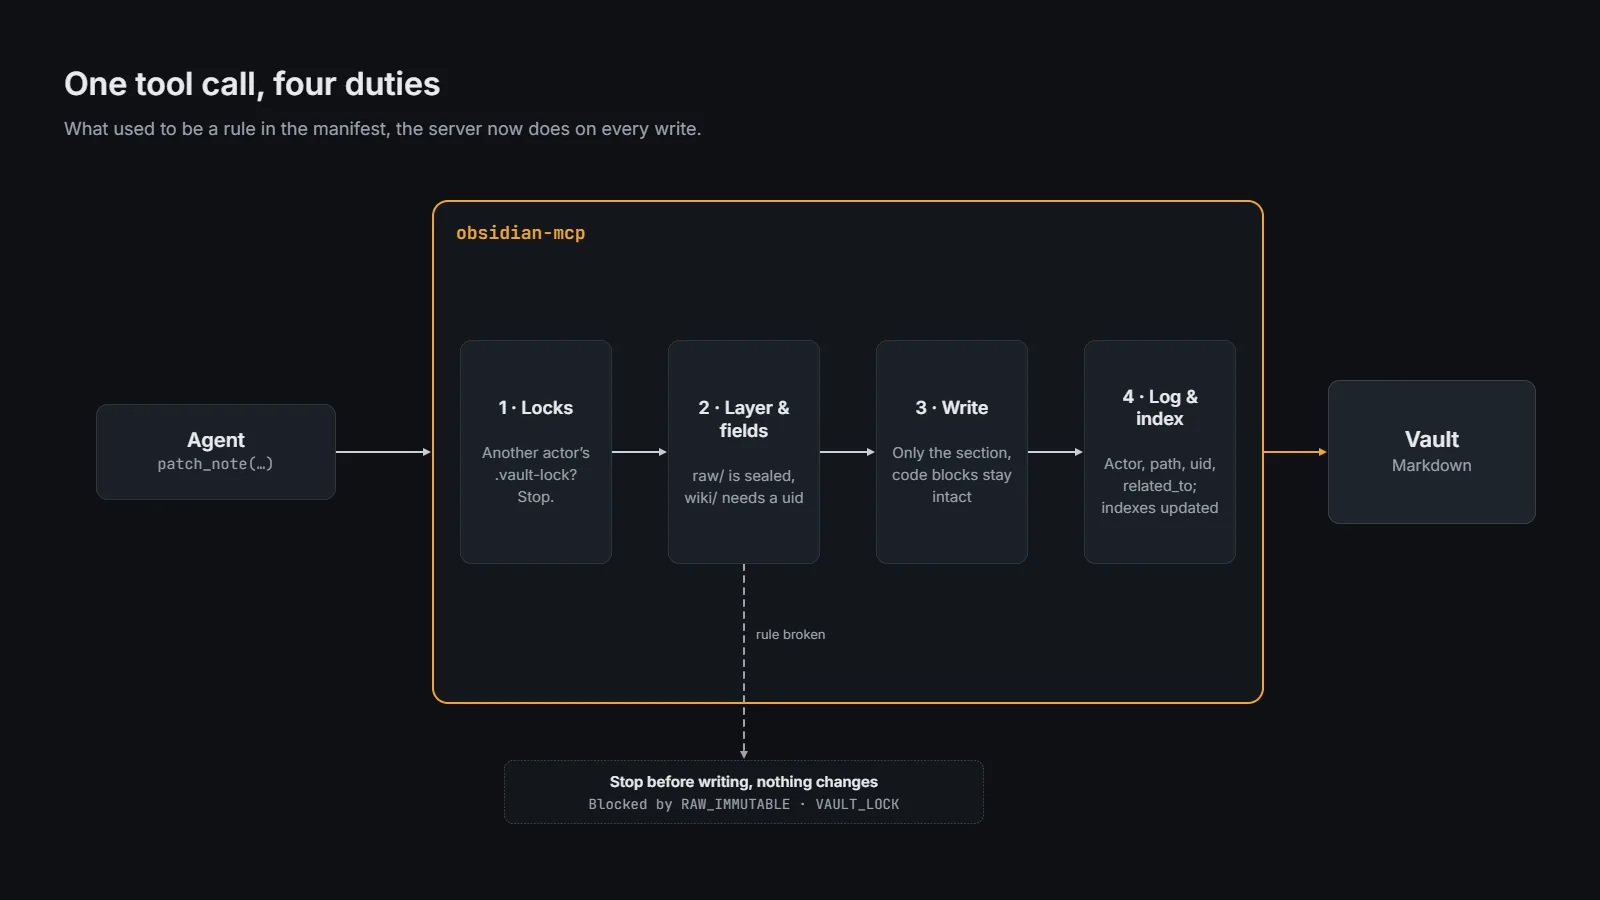
Bei mir liegt zwischen den Agenten und dem Speicher inzwischen ein eigener Server. Er spricht MCP, das Model Context Protocol. Der ursprünglich von Anthropic entwickelte Standard liegt inzwischen unter dem Dach der Linux Foundation und wird von Plattformen wie ChatGPT, Gemini und Microsoft Copilot unterstützt. Ein eigenes Protokoll musste ich deshalb nicht erfinden. Wohl aber einen eigenen Server. Viele bekannte Obsidian-MCP-Projekte setzen eine laufende Desktop-App samt lokalem Plug-in voraus. Auf einem Linux-Root-Server im Container-Betrieb ohne grafische Oberfläche sind sie unbrauchbar. Und generische Dateisystem-Server kennen wiederum die Architektur- und Schreibregeln meines Speichers nicht. Mein Server arbeitet deshalb headless direkt auf dem Markdown-Bestand und setzt die Regeln des Speichers selbst durch.
Der Agent bekommt über diese Schnittstelle keinen rohen Dateizugriff mehr, sondern domänengebundene Werkzeuge mit festen Antwort-Schemas. Statt ganze Dateien blind zu überschreiben, aktualisiert er gezielt einzelne Abschnitte unter einer Überschrift, ohne Codeblöcke zu beschädigen. Er verwaltet Metadaten und Tags isoliert und prüft verwaiste Notizen oder archiviert Einträge erst nach einem Backlink-Check. Und rund um jeden Schreibvorgang erledigt der Server im selben Zug, was im ersten Artikel noch als Verhaltensregel im Manifest stand:
– Sperren prüfen: vorab kontrollieren, ob eine aktive Sperrdatei eines anderen Akteurs vorliegt, und die anschließende Aktualisierung des Wiki-Indexes über eine eigene Dateisperre absichern
– Schichten und Pflichtfelder erzwingen: prüfen, ob der Pfad überhaupt beschrieben werden darf und ob Pflicht-Metadaten wie eindeutige IDs vorhanden sind
– Herkunft protokollieren: welcher Akteur, welcher Pfad, welche Inhalts-ID, welcher Auslöser (related_to) und wann
– Ordnung halten: den Volltext- und Wiki-Index nachziehen. Verweise lassen sich gezielt auf Brüche prüfen
Aus Architektursicht ist das ein Musterwechsel. Ohne diese Kontrollschicht müsste der Agent die Schritte selbst orchestrieren: Sperren prüfen, Datei ändern, Protokoll ergänzen und Indizes nachziehen. Vergisst das Modell einen Schritt oder hält die Reihenfolge nicht ein, kann der Speicher auseinanderdriften. Mit dem Server startet ein einziger Werkzeugaufruf die Verarbeitung. Die Schreibregeln liegen vorab im Code, die Protokollierung und Indexpflege übernimmt anschließend der Server. Das Modell muss diese Abläufe nicht selbst zusammenhalten.
Regeln ziehen damit von der Textanweisung in die Schnittstelle und eine Schnittstelle wirkt immer, auch mitten in der Nacht, auch beim Agenten, den ich erst nächste Woche anbinde. Ein Nebeneffekt ist, dass der Prompt schrumpft, denn Abläufe, die der Server übernimmt, muss ich keinem Modell mehr im Kontext erklären. Wer einmal eine mehrseitige Schreibordnung aus einem System-Prompt löschen konnte, will sie nicht zurück.
Regeln, die nicht umgangen werden können
Wie schon im ersten Teil beschrieben, gilt in meinem Speicher eine klare Trennung: eine raw-Schicht für unveränderliche Quellen, eine wiki-Schicht für aufbereitetes Wissen und eine system-Schicht für Regeln und Betrieb, flankiert von den Ordnern für die laufende Projektarbeit. Die Quellschicht ist nach der Aufnahme versiegelt.
Vor ein paar Tagen wollte ich eine veraltete Recherche-Notiz in den Quellen aktualisieren. Ich hatte gute Gründe dafür, war der Betreiber des Systems und gab die Anweisung direkt im Chat an meinen Agenten. Der Server hat den Schreibvorgang trotzdem abgewiesen: RAW_IMMUTABLE. Gesperrte Schicht, keine Ausnahme. Ein Prompt hätte sich von meiner Admin-Rolle vermutlich überreden lassen, dem Code ist meine Rolle schlicht egal. Wenn eine Quelle überholt ist, entsteht eine neue Notiz oder eine Synthese im Wiki. Die ursprüngliche Evidenz bleibt unangetastet.
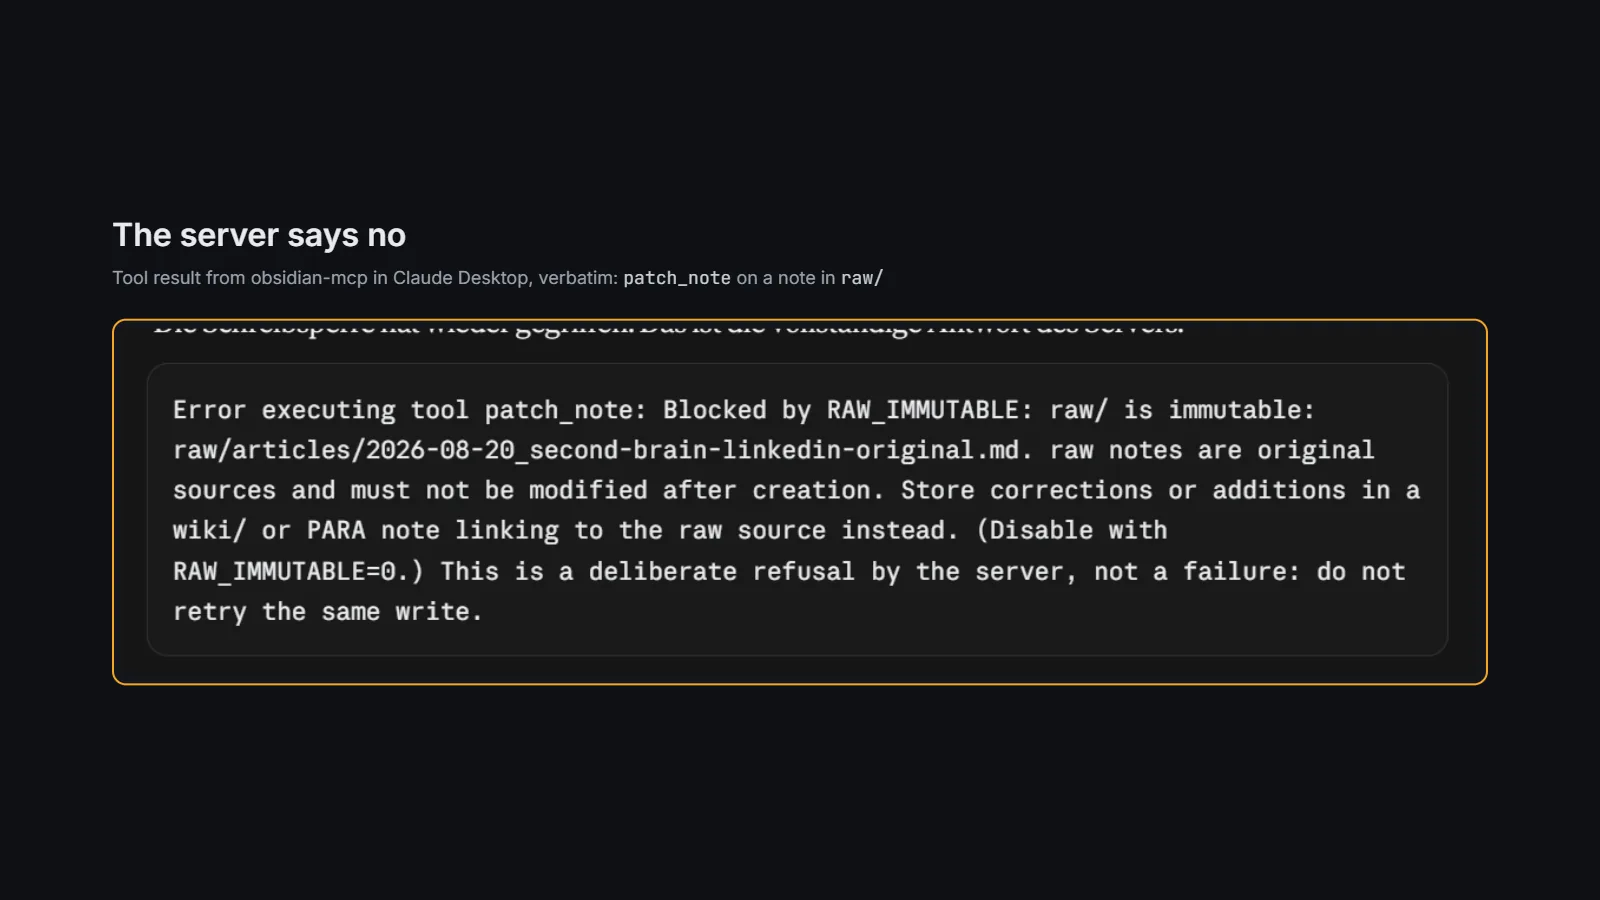
Voraussetzung dafür ist, dass den Agenten der direkte Dateisystemzugriff entzogen ist und jeder Zugriff über die Werkzeuge des Servers läuft. Damit ein Agent diese Kontrolle nicht über die eigenen Werkzeuge aushebelt, schützt der Server seine Infrastruktur über eine Deny-List. Weder das Schreibprotokoll noch die Sperrdateien, der zentrale Wiki-Index oder die Obsidian-Konfiguration lassen sich über Agenten-Werkzeuge verändern oder per Suchen-und-Ersetzen manipulieren. Der Server schreibt das Protokoll, der Agent darf es über die Schnittstelle nicht einmal anfassen.
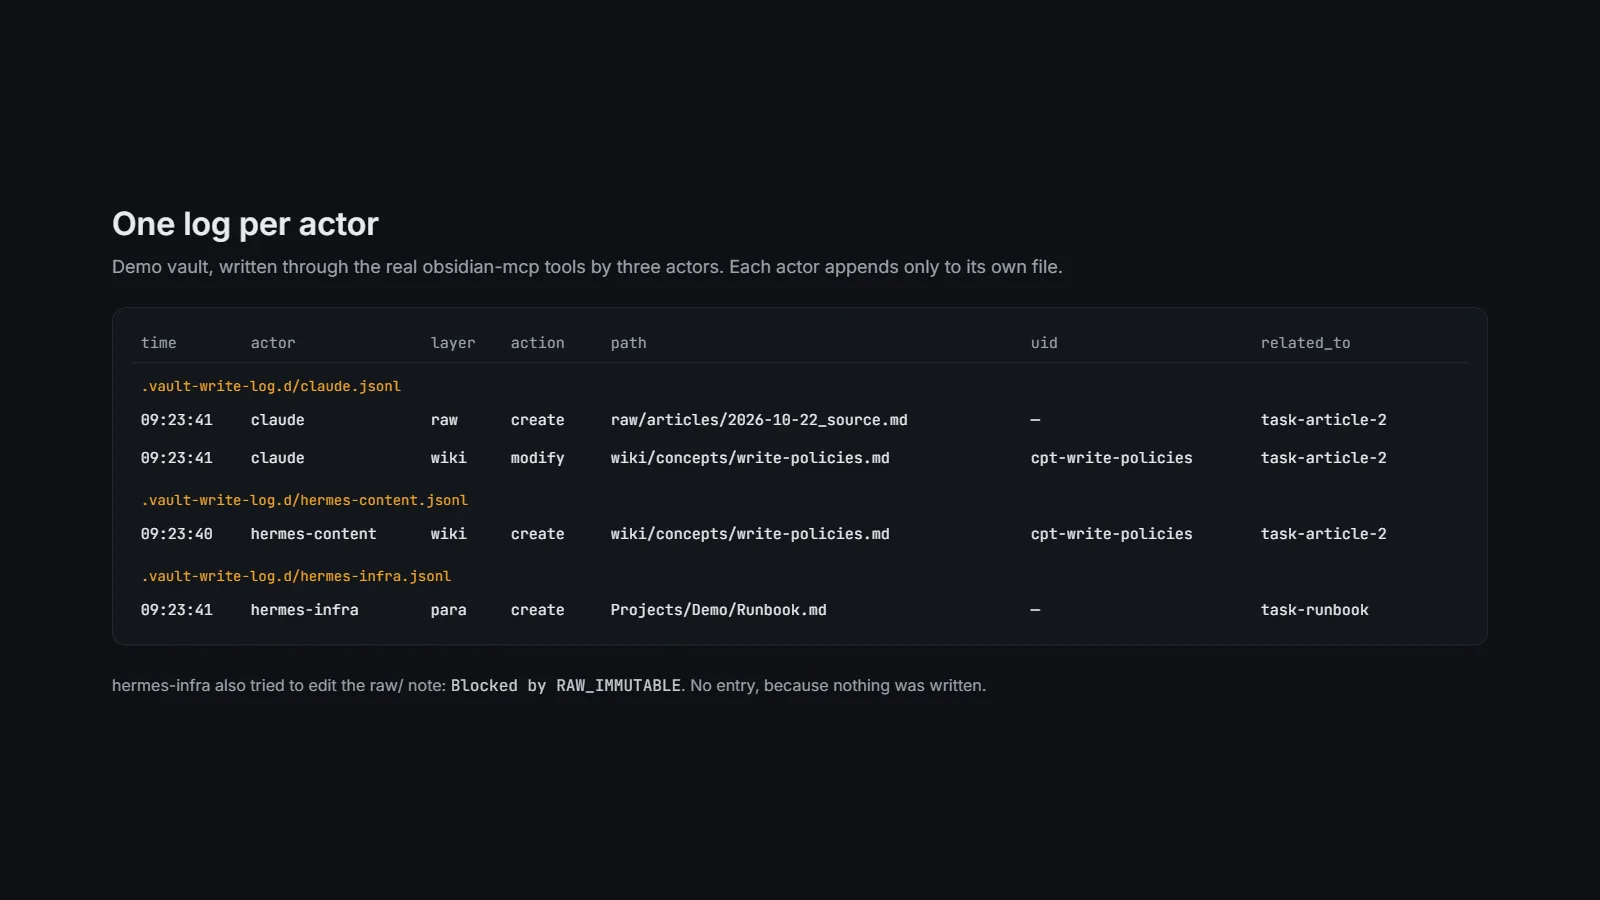
Zusätzlich führt der Server für jeden Akteur eine eigene Protokollspur, damit sich parallel arbeitende Agenten beim Loggen nicht gegenseitig überschreiben. Für eine Organisation heißt das: Protokollierte Agenten-Aktionen lassen sich nachvollziehen, ohne darauf hoffen zu müssen, dass das Modell seine Buchhaltung selbst erledigt. Vorher war das ein Versprechen im Manifest. Jetzt übernimmt der Server die Protokollierung und schützt das Protokoll vor Änderungen über die Agenten-Schnittstelle. Mit einem Prompt wäre das undenkbar.
Ein Speicher, alle Agenten, dieselbe Wahrheit
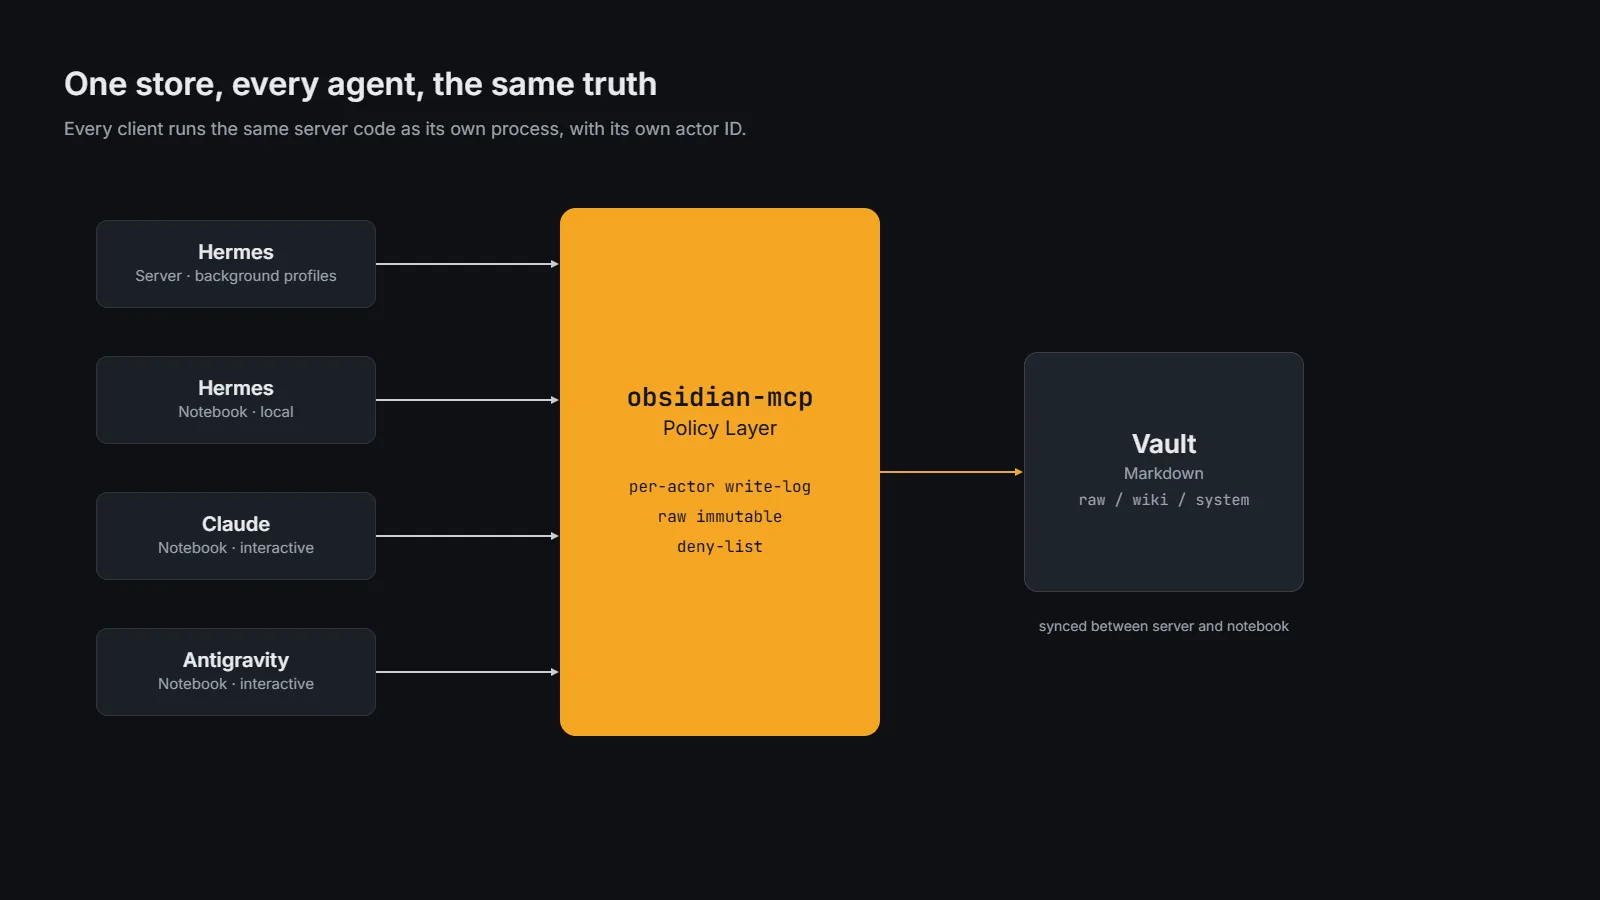
Was ich am Anfang unterschätzt habe: Der Kontrollpfad skaliert mit den Clients. Bei mir arbeiten dauerhaft laufende Hintergrund-Agenten (Hermes-Profile) auf dem Linux-Server, mein lokaler Hermes-Agent auf dem Notebook sowie interaktive Clients wie Claude und Antigravity auf demselben Wissensbestand.
Jeder Client startet dabei denselben MCP-Server-Code als eigenen Prozess mit einer eigenen Akteur-Kennung (VAULT_ACTOR). Die Protokollierung erfolgt getrennt pro Akteur. Vor einem Schreibvorgang prüft der Server außerdem, ob eine aktuelle Sperrdatei eines anderen Akteurs vorliegt, und sichert die Aktualisierung des Wiki-Indexes separat über eine Dateisperre ab. Der binäre Suchindex liegt außerhalb des synchronisierten Ordners. Zwischen Server und Notebook werden der Markdown-Bestand und die zugehörigen Protokoll- und Indexdateien übertragen, während gleichzeitige Änderungen derselben Datei auf beiden Maschinen Aufgabe der Dateisynchronisierung bleiben. Ein zusätzlicher Agent muss die Speicherregeln damit nicht neu implementieren, sondern bekommt schlicht dieselbe Schnittstelle vorgesetzt.
Das Manifest aus dem ersten Artikel beschreibt, was gilt. Die gemeinsame Server-Implementierung sorgt dafür, dass es für jeden Client nach denselben Regeln durchgesetzt wird. Das Eine-zu-viele-Problem der Agenten-IT bekommt damit eine definierte Schicht, an der man ansetzen kann.
MCP ist kein Sicherheitsgarant
Jetzt folgt der ehrliche Teil. Ein Standard, der Schnittstellen vereinheitlicht, vereinheitlicht auch die Angriffsfläche. Die OWASP (Open Worldwide Application Security Project) führt inzwischen eine eigene Top 10 für MCP‑Risiken. Dabei muss man zwei Angriffspfade unterscheiden:
Der erste Pfad trifft den Client über fremde Server oder manipulierte Konfigurationen. Invariant Labs hat gezeigt, wie manipulierte Werkzeugbeschreibungen (Tool Poisoning) einen Agenten zur Weitergabe vertraulicher Inhalte verleiten können. Mit MCPTox haben Forschende solche Angriffe systematisch untersucht und erhebliche Schwächen bei den getesteten Agenten festgestellt. Ein inzwischen behobener Fall in Cursor (MCPoison) zeigte außerdem, wie manipulierte MCP-Konfigurationen zur Ausführung von Code mit Nutzerrechten führen konnten.
Der zweite Pfad betrifft den eigenen Wissensbestand. Eine Prompt-Injection in einer gelesenen Webseite oder E-Mail kann einen Agenten mit unkontrolliertem Dateisystemzugriff zu unerwünschten Schreiboperationen verleiten.
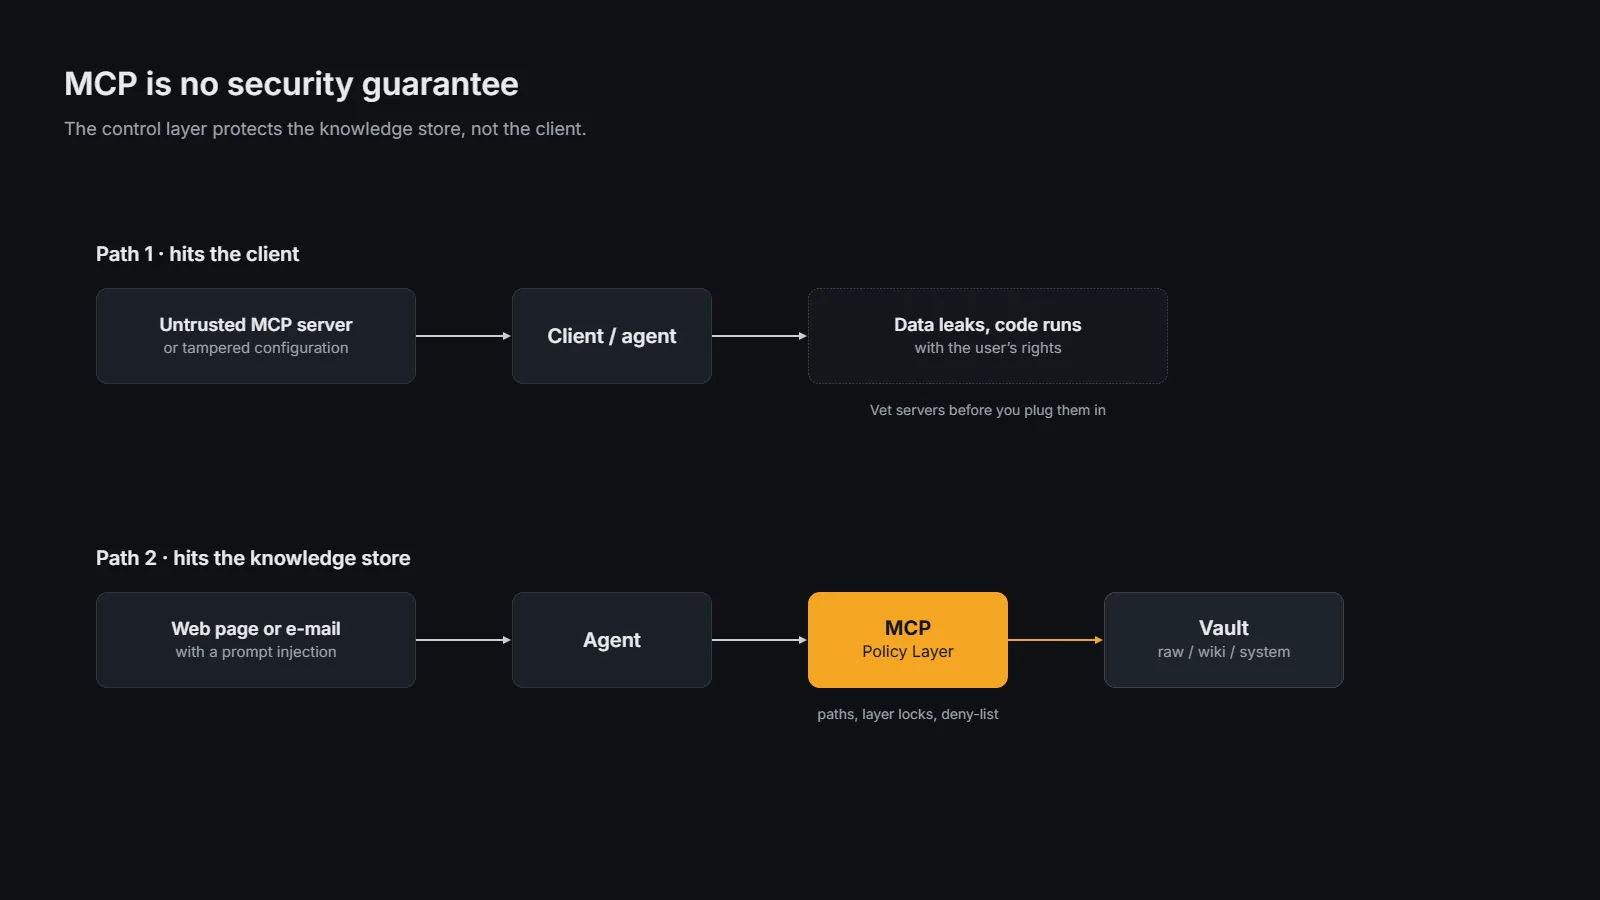
Entscheidend ist deshalb nicht, ob ein Agent MCP nutzt, sondern wie sein Zugriff auf die dahinterliegenden Daten kontrolliert wird. Wer fremde MCP-Server blind einbindet, holt sich ein Supply-Chain-Risiko ins Haus. Und wer Agenten ganz ohne Kontrollschicht direkt auf Dateien loslässt, hat kein kleineres Angriffsziel, nur ein unsichtbares. Mir liegt also daran zu betonen: Der Standard selbst ist nicht die Sicherheitslösung. Er schafft aber eine definierte Schnittstelle, an der ich die Zugriffe auf meinen Wissensbestand kontrollieren kann, inklusive Pfadbeschränkungen, Schicht-Sperren und einer Deny-List. Entscheidend bleibt, dass es für die Agenten keinen unkontrollierten Zugriffsweg am Server vorbei gibt. Eine Richtlinie wirkt nur, wenn jeder relevante Zugriff durch die Kontrollschicht läuft. Andernfalls bleibt sie eine Empfehlung.
Der Preis: bauen, testen, betreiben
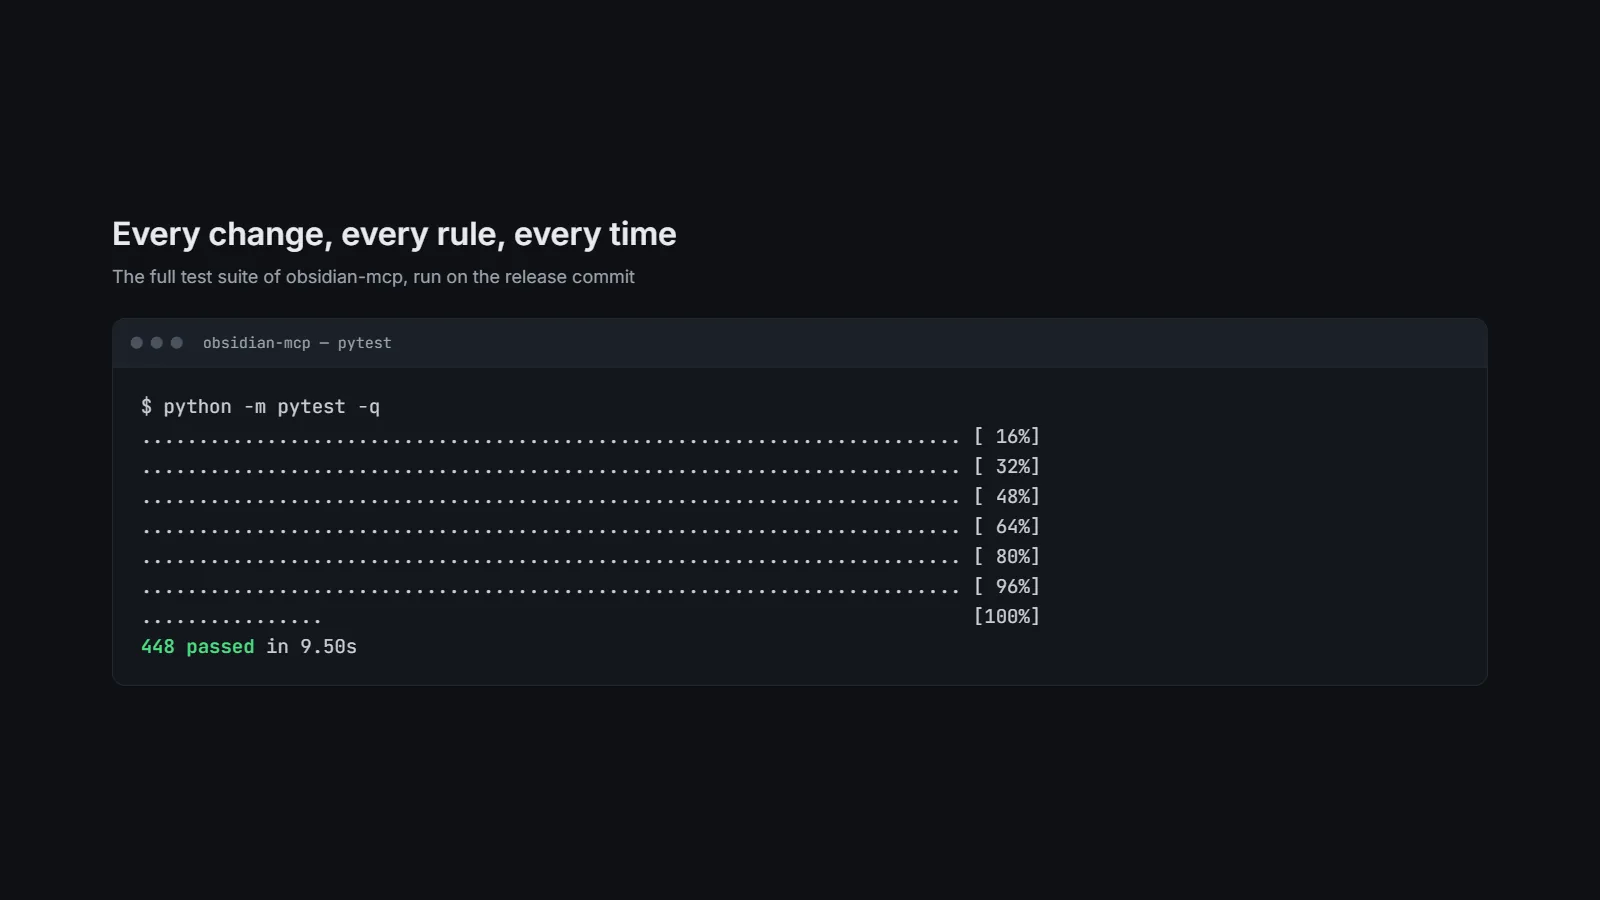
Solch eine Schicht erstellt sich nicht von selbst. Ich habe den Server selbst gebaut und er wird laufend getestet. Mehr als 400 automatisierte Prüfungen laufen bei jeder Änderung und jede fünfte davon testet die Regeln, Sperren und Grenzwerte selbst, nicht nur die Grundfunktionen. Dazu kommen der laufende Betrieb und die Disziplin, bei jedem neuen Werkzeug vorab zu entscheiden, was ein Agent damit anrichten darf.
Wer diesen Aufwand nicht selbst betreiben möchte, kann eine Plattform nutzen, bei der der Anbieter die Durchsetzung der Regeln übernimmt. Das ist eine legitime Entscheidung. Die meisten Probleme verursacht meiner Meinung nach der Mittelweg: Agenten erhalten weitreichenden Zugriff auf wichtige Verzeichnisse, während ein langer Prompt sie lediglich daran erinnert, vorsichtig zu sein.
Im nächsten Teil der Serie geht es um die semantische Erweiterung: Was passiert, wenn Wissensbestände so groß werden, dass Struktur und Volltextsuche allein nicht mehr reichen?
Der Server ist Open Source: github.com/nakielski/obsidian-mcp
Ein Agent, der alles darf, ist kein Kollege, sondern ein Risiko.
Wie steuert ihr den Zugriff eurer Agenten auf zentrale Wissensbestände: über Vertrauen im Prompt, externe Kontrollsysteme oder über eine eigene Kontrollschicht?